 AI Summary Helper
لماذا نقلنا البحث والوسوم والتوصيات خارج السحابة
يتشارك البحث، وإزالة التكرار، وتنظيم الوسوم، والتوصيات في فهرس محلي واحد خفيف. إليك كيف يعمل ذلك، ولماذا لا يقتصر الأمر على مجرد شعار للخصوصية.
ترسل معظم إضافات المتصفح "المدعومة بالذكاء الاصطناعي" كل شيء إلى خادم خارجي — بما في ذلك أجزاء لا علاقة لها بالذكاء الاصطناعي على الإطلاق. فالبحث وتنظيم الوسوم و"العثور على عناصر مشابهة" هي تقنيات راسخة ومفهومة منذ عقود؛ ولا تحتاج إلى نموذج لغوي، وبالتأكيد لا تحتاج إلى اتصال عبر الشبكة. راجعنا كل ميزة في AI Summary Helper وسألنا أنفسنا: هل تحتاج هذه الميزة حقًا إلى السحابة، أم أننا نعتمد عليها تلقائيًا لمجرد أنها البنية الأسهل؟
معظمها لم يكن بحاجة إليها مطلقًا.
ما تم نقله فعليًا ليعمل على الجهاز
البحث. في البداية، كانت الإضافة تطابق فقط عبر عنوان المقال والوسوم — وكان ذلك سريعًا، لكنه يتجاهل محتوى المقال بالكامل. بدلاً من الفحص الشامل للنص الكامل مع كل ضغطة زر، أو إرسال كل استعلام إلى خادم، قمنا ببناء فهرس TF-IDF محلي خفيف من أرشيف المستخدم المحفوظ. تُفحص الحقول البسيطة — العنوان والوسوم — أولاً وفورًا كما كان من قبل. بينما تُوسّع الاستعلامات الأطول مقابل الفهرس، الذي يُبنى مرة واحدة لكل جلسة ويُحدّث تدريجيًا، دون إعادة الفحص مع كل نقرة مفتاح.
اكتشاف المحتوى المكرر. قبل إتمام الحفظ، يتم تشغيل فحص متعدد المستويات: مطابقة دقيقة للرابط بعد توحيد صيغته أولاً (فحص سريع بتعقيد O(1))، ثم تشابه العناوين على المرشحين القلائل الذين اجتازوا ذلك، وفقط لهؤلاء القلة المتبقين — يُجرى مقارنة كاملة لتشابه جيب التمام عبر TF-IDF. معظم عمليات الحفظ لا تصل إطلاقًا إلى المستوى المتقدم عالي الكلفة، لأن المستويات الأولية تحسم الأمر مسبقًا.
توحيد صيغ الوسوم. تتراكم الاختلافات في الوسوم بمرور الوقت — مثل "ML" و"Machine Learning" و"machine-learning"؛ وكلها تعني نفس الشيء للإنسان ولكنها مختلفة تمامًا لمحركات التصفية. يلتقط جدول أسماء مستعارة صغير الحالات الواضحة؛ بينما يتولى دمج المسافة التحريرية التقريبية (fuzzy edit-distance) عبر كامل قاموس الوسوم الباقي، مع اختيار الصيغة التي استخدمها المستخدم أكثر كصيغة قياسية بدلاً من فرض صيغة "صحيحة" عليه.
سهولة القراءة ونبرة النص. مقياس Flesch–Kincaid لسهولة القراءة هو مجرد عملية حسابية بسيطة لعدد الجمل والمقاطع الصوتية — لا يحتاج إلى نموذج ذكاء اصطناعي. أما تحليل المشاعر فيعتمد على قائمة كلمات AFINN مدمجة مع فحص بسيط لأدوات النفي في الرمزين السابقين. لم يكن أي من هذين الأمرين بحاجة إلى مغادرة المتصفح.
"المقالات المشابهة" والملخص الموجز (Digest). يعيد كلاهما استخدام نفس متجهات TF-IDF التي أنشأها البحث بالفعل. كان من السهل بناء ثلاثة أنظمة تشابه منفصلة لثلاث ميزات مختلفة. لكن بناء فهرس واحد وجعل البحث والتوصيات وإعداد الملخصات تقرأ منه حافظ على صغر حجم النظام ككل، وجعل تحسين الفهرس مرة واحدة بمثابة ترقية للميزات الثلاث معًا.
ما تركناه عمدًا في السحابة
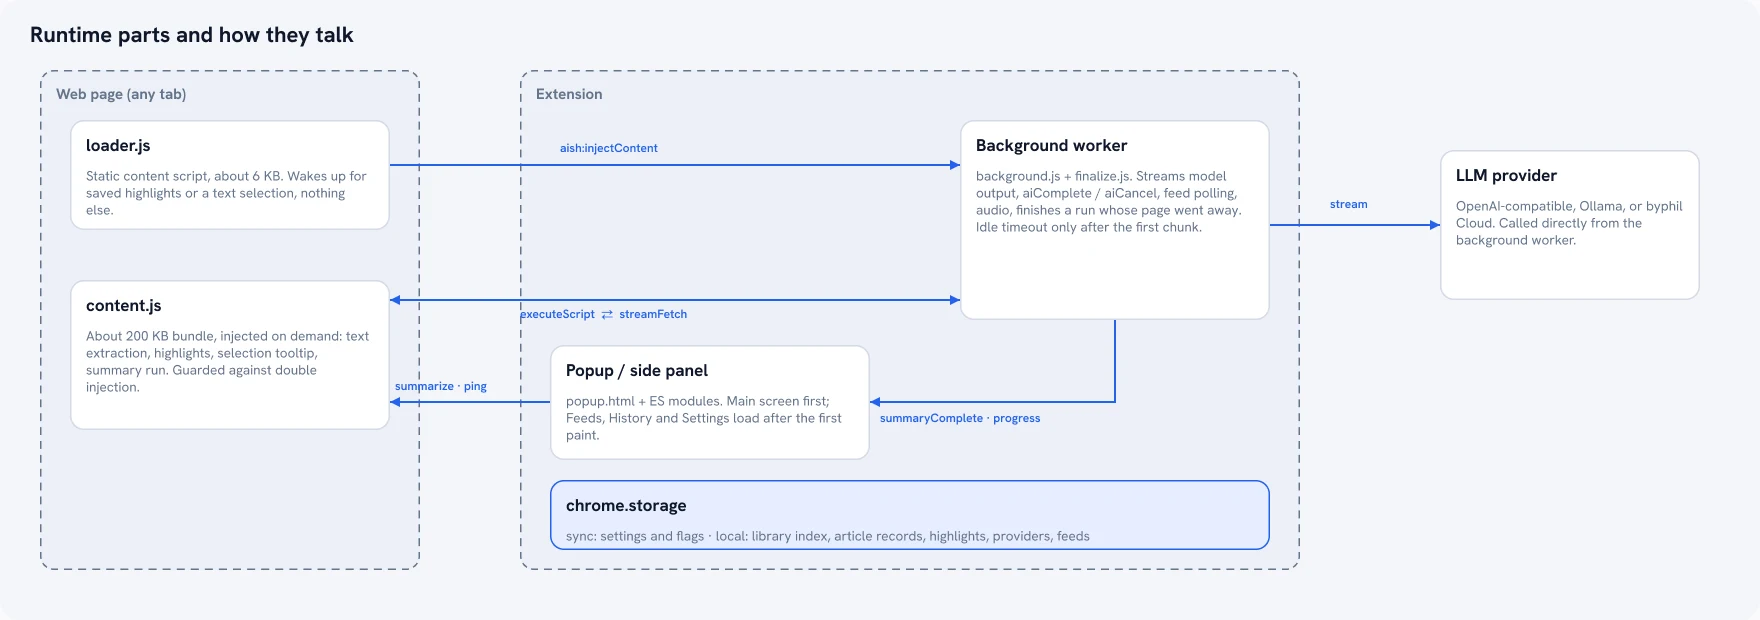
خطوة التلخيص الفعلية — الجزء الذي يتطلب نموذجًا لغويًا حقيقيًا — لا تزال بحاجة إلى اتصال بالشبكة. لا يمكن تجاوز ذلك مع أحجام النماذج الحالية على الأجهزة إذا كنت تريد جودة تضاهي نماذج السحابة. يجلب المستخدمون مفتاح الـ API الخاص بهم لهذه الخطوة (OpenAI أو Gemini أو Mistral أو DeepSeek)، أو يوجهون الإضافة إلى خادم Ollama محلي للاستغناء عن الشبكة في هذه الخطوة أيضًا. هذا هو المكان الوحيد الذي لا يكون فيه التشغيل "على الجهاز" هو الخيار الافتراضي — بل خيارًا اختياريًا، لأن المفاضلة هنا حقيقية: فالنموذج المحلي أبطأ وأقل جودة من النموذج المستضاف، ولم نرد التظاهر بغير ذلك.
لماذا يتجاوز الأمر كونه مجرد نقطة نقاش حول الخصوصية
جانب الخصوصية حقيقي ومهم — فإضافة متصفح ذات أذونات وصول واسعة ترسل محتوى الصفحات إلى خادم لأمور لا تتطلب ذلك تمثل تساؤلًا مشروعًا حول الثقة، وليس مجرد مظهر خارجي. لكن السبب الهندسي الأبسط للقيام بذلك هو أنه الخيار التقني الصحيح في أغلب الأحيان. فبحث TF-IDF لا يحتاج إلى تأخير استجابة شبكي يبلغ 200ms. وإزالة تكرار الوسوم لا تتطلب فاتورة استهلاك API. إن مطابقة الأداة مع المهمة المطلوبة فعليًا، بدلاً من توجيه كل شيء عبر "الاتصال بالسحابة" افتراضيًا، ينتج عادةً أداءً أسرع، وأقل تكلفة، وأكثر مرونة عند انقطاع الاتصال — وتأتي ميزة الخصوصية كقيمة مضافة مجانية وتلقائية، وليس العكس.
إن AI Summary Helper هو امتداد مجاني لمتصفح Chrome.
أضف إلى Chrome