 AI Summary Helper
Hvorfor vi flyttede søgning, tagging og anbefalinger ud af skyen
Søgning, duplikattjek, tag-oprydning og anbefalinger deler ét lille indeks på din enhed. Se hvordan det fungerer, og hvorfor det handler om mere end bare privatliv.
De fleste »AI-drevne« browserudvidelser sender alt til en server — også de dele, der intet har med AI at gøre. Søgning, oprydning i tags, »find lignende artikler«: det er velafprøvede teknikker, der har eksisteret i årtier. De kræver ikke en sprogmodel, og de behøver slet ikke en tur over netværket. Vi gennemgik AI Summary Helper funktion for funktion og spurgte: behøver dette overhovedet skyen, eller gør vi det bare, fordi det er den nemme arkitektur?
Det meste behøvede det slet ikke.
Hvad der rent faktisk blev flyttet lokalt
Søgning. Oprindeligt matchede udvidelsen kun på artikeltitel og tags — hurtigt, men blindt over for selve brødteksten. I stedet for at gennemsøge fuldtekst ved hvert tastetryk eller sende hver søgning til en server, byggede vi et lille TF-IDF-indeks ud fra dit eget gemte arkiv. Lette felter — titel, tags — tjekkes først og med det samme, præcis som før. Længere søgninger udvides mod indekset, som opbygges én gang per session og opdateres løbende uden at genindlæse ved hvert tastetryk.
Duplikatregistrering. Før en side gemmes, køres et trinopdelt tjek: først et præcist, normaliseret URL-match (hurtigt, O(1)), derefter titellighed på de få kandidater, der slipper igennem, og først derefter — for de resterende få — en fuld TF-IDF cosinus-lighedsberegning. De fleste gemte sider når aldrig det tunge trin, fordi de lette trin allerede har afklaret det.
Tag-normalisering. Tags skrider over tid — »ML«, »Machine Learning« og »machine-learning« betyder det samme for et menneske, men vidt forskellige ting for et filter. En lille aliastabel fanger de oplagte tilfælde; en fuzzy edit-distance-sammenfletning på tværs af alle tags klarer resten og vælger den stavemåde, du oftest har brugt, som standard frem for at gennemtvinge en bestemt form.
Læsbarhed og tone. Flesch–Kincaid-læsbarhed er ren matematik på sætnings- og stavelsesantal — ingen model påkrævet. Stemningsanalyse er en integreret AFINN-ordliste med et simpelt negationstjek på de to forudgående tokens. Ingen af delene behøver at forlade din browser.
»Lignende artikler« og Digest. Begge genbruger præcis de samme TF-IDF-vektorer, som søgningen allerede har opbygget. Det ville have været nemt at bygge tre separate systemer til tre funktioner. Ved at nøjes med ét indeks, som søgning, anbefalinger og opsummering alle trækker på, holdt vi systemet kompakt — og forbedringer af indekset gavner automatisk alle tre funktioner på én gang.
Hvad vi bevidst lod blive i skyen
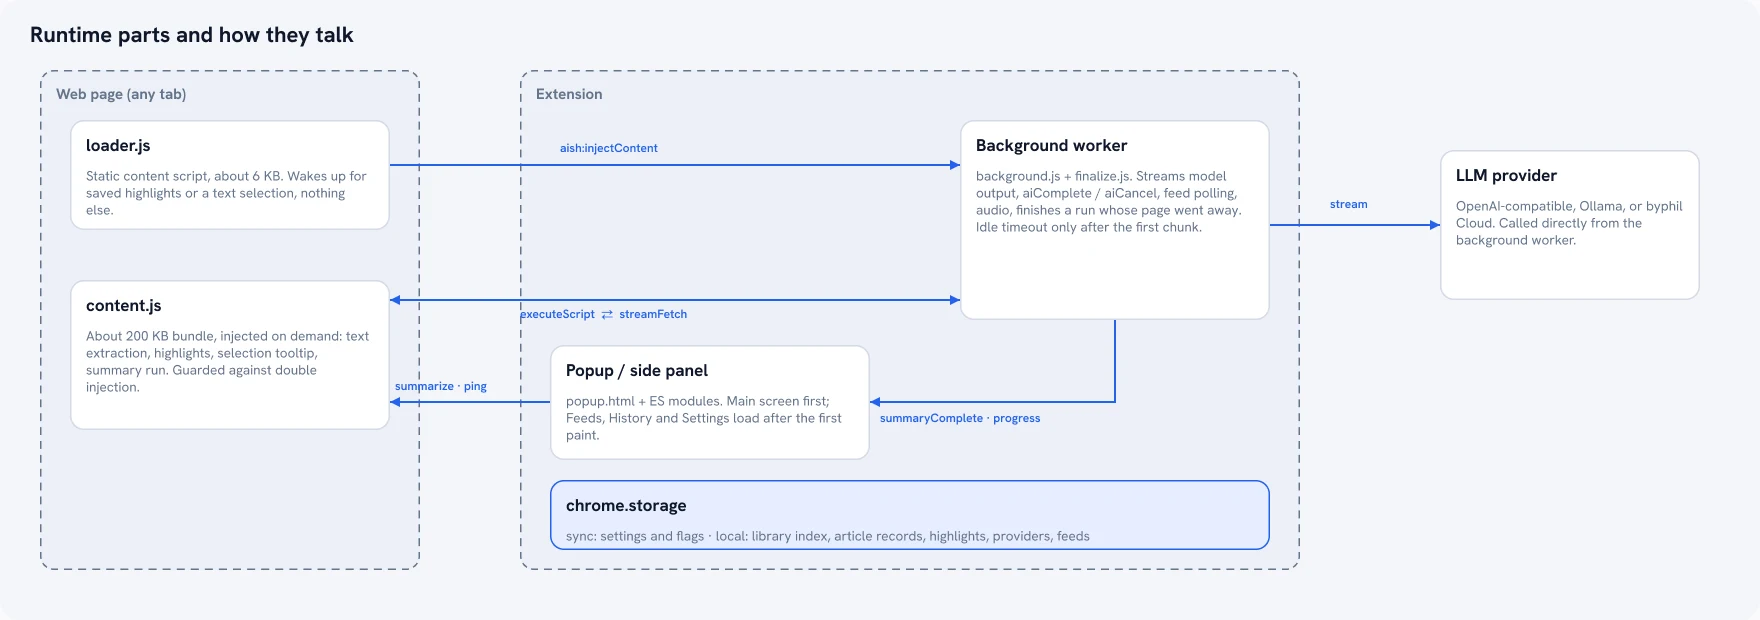
Selve opsummeringstrinnet — den del, der rent faktisk kræver en sprogmodel — kræver stadig et netværkskald. Det kommer man ikke uden om med nuværende lokale modelstørrelser, hvis man vil have cloud-kvalitet. Du medbringer din egen API key til det trin (OpenAI, Gemini, Mistral, DeepSeek) eller forbinder udvidelsen til en lokal Ollama-instans og slipper helt for netværkskald dér også. Det er det eneste sted, hvor lokal kørsel er et tilvalg frem for standarden. Afvejningen er reel: en lokal model er langsommere og leverer lavere kvalitet end en hostet model, og det vil vi ikke lægge skjul på.
Hvorfor det handler om mere end bare privatliv
Privatlivsaspektet er afgørende — en udvidelse med brede tilladelser, der sender sideindhold til en server for ting, der ikke behøver det, er et reelt tillidsspørgsmål og en vigtig overvejelse under GDPR. Men den mere pragmatiske grund er, at det simpelthen er bedre ingeniørarbejde. TF-IDF-søgning behøver ikke 200 ms netværksforsinkelse. Tag-oprydning behøver ikke en API-regning. Når man vælger det rette værktøj til opgaven i stedet for at sende alt i skyen som standard, får man noget, der er hurtigere, billigere i drift og fungerer offline — og den stærke databeskyttelse følger automatisk med.
AI Summary Helper er en gratis Chrome-udvidelse.
Tilføj til Chrome