 AI Summary Helper
Miksi siirsimme haun, tunnisteet ja suositukset pois pilvestä
Haku, kaksoiskappaleiden karsinta, tunnisteiden siivous ja suositukset jakavat yhden pienen paikallisen indeksin. Näin se toimii — ja miksi kyse ei ole vain yksityisyydellä markkinoinnista.
Useimmat tekoälypohjaiset selainlaajennukset lähettävät kaiken palvelimelle — myös toiminnot, joilla ei ole mitään tekemistä tekoälyn kanssa. Haku, tunnisteiden siivous ja "löydä samankaltaisia" ovat vuosikymmeniä vanhoja, perusteellisesti ymmärrettyjä tekniikoita. Ne eivät vaadi kielimallia eivätkä varsinkaan verkkoliikennettä. Kävimme AI Summary Helperin toiminnot läpi yksitellen ja kysyimme: tarvitseeko tämä oikeasti pilveä, vai käytämmekö sitä vain siksi, että se on helpoin arkkitehtuuri?
Suurin osa ei tarvinnut.
Mitä oikeasti siirrettiin suoritettavaksi paikallisesti
Haku. Laajennus haki alun perin vain artikkelin otsikosta ja tunnisteista — se oli nopeaa, mutta jätti leipätekstin huomiotta. Sen sijaan, että koko tekstiä skannattaisiin raskaasti jokaisella näppäinpainalluksella tai jokainen haku lähetettäisiin palvelimelle, rakensimme pienen TF-IDF-indeksin suoraan tallentamastasi arkistosta. Kevyet kentät — otsikko ja tunnisteet — tarkistetaan heti kuten ennenkin. Laajemmat haut sovitetaan indeksiin, joka luodaan kerran istuntoa kohden ja päivitetään vaiheittain eikä skannata uudelleen joka painalluksella.
Kaksoiskappaleiden tunnistus. Ennen kuin tallennus valmistuu, suoritetaan porrastettu tarkistus: ensin tarkka normalisoitu URL-haku (nopea, O(1)), sitten otsikon samankaltaisuus niille harvoille ehdokkaille, jotka läpäisevät ensimmäisen vaiheen, ja vasta lopuksi — jäljelle jääville — täysi TF-IDF-kosinivertailu. Useimmat tallennukset eivät koskaan etene raskaaseen vaiheeseen asti, koska kevyet vaiheet ratkaisevat asian jo aiemmin.
Tunnisteiden normalisointi. Tunnisteet pirstaloituvat ajan myötä — "ML", "Machine Learning" ja "machine-learning" tarkoittavat ihmiselle samaa asiaa, mutta suodattimelle täysin eri asioita. Pieni aliastaulukko nappaa ilmeisimmät tapaukset; sumea editointietäisyyteen perustuva yhdistäminen koko tunnistekannasta hoitaa loput. Se valitsee viralliseksi muodoksi sen kirjoitusasun, jota olet käyttänyt eniten, sen sijaan että se pakottaisi jonkin "oikean" muodon.
Luettavuus ja sävy. Flesch–Kincaid-luettavuustaso on puhdasta aritmetiikkaa virke- ja tavumääristä — mallia ei tarvita. Mielialan analyysi perustuu mukana toimitettuun AFINN-sanalistaan ja pieneen negaatiotarkistukseen kahta edeltävää sanaa vasten. Kummankaan ei tarvinnut poistua selaimesta.
"Samankaltaiset artikkelit" ja Kooste. Molemmat käyttävät samoja TF-IDF-vektoreita, jotka haku on jo luonut. Olisi ollut helppoa rakentaa kolme erillistä samankaltaisuusjärjestelmää kolmelle eri toiminnolle. Rakentamalla yhden indeksin ja antamalla haun, suositusten ja koosteiden hyödyntää sitä saimme kokonaisjärjestelmästä kevyemmän — ja indeksin parantaminen nopeutti kaikkia kolmea ominaisuutta kerralla.
Mitä jätimme tarkoituksella pilveen
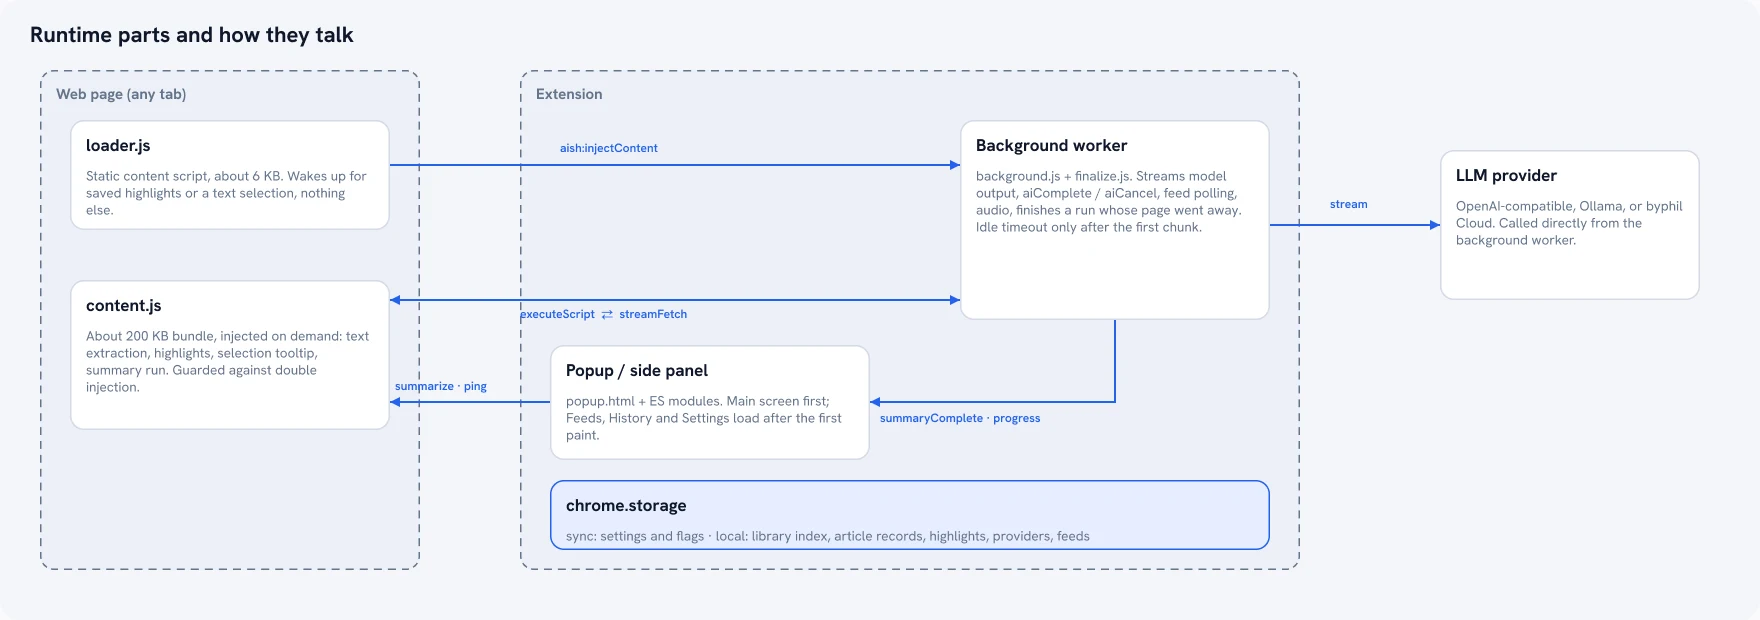
Varsinainen tiivistysvaihe — osa, joka aidosti vaatii kielimallia — vaatii edelleen verkkokutsun. Tätä ei voi nykyisillä paikallisten mallien kooilla ohittaa, jos halutaan pilvitason mallien laatu. Voit käyttää vaiheessa omaa API key -avaintasi (OpenAI, Gemini, Mistral, DeepSeek) tai ohjata laajennuksen paikalliseen Ollama-asennukseen ja ohittaa verkkoliikenteen myös tässä vaiheessa. Tämä on ainoa kohta, jossa paikallisuus ei ole oletusasetus vaan valinnainen asetus, koska kompromissi on todellinen: paikallinen malli on hitaampi ja laadultaan vaatimattomampi kuin isännöity malli, emmekä halunneet väittää muuta.
Miksi tämä on enemmän kuin vain tietosuojapuhetta
Yksityisyysnäkökulma on aito — laajennus, jolla on laajat käyttöoikeudet ja joka lähettää sivun sisältöä palvelimelle tarpeettomasti, on perusteltu luottamuskysymys, ei pelkkää imagonrakennusta. Mutta arkisempi syy tälle on se, että se on teknisesti oikea ratkaisu. TF-IDF-haku ei tarvitse 200 millisekunnin verkkoviiveitä. Tunnisteiden kaksoiskappaleiden karsinnan ei tarvitse kerryttää API-laskua. Kun työkalu valitaan todellisen tarpeen mukaan sen sijaan, että kaikki ohjattaisiin oletuksena pilveen, lopputuloksena on nopeampi, edullisempi ja paremmin offline-tilassa toimiva ratkaisu — tietosuoja tulee kaupan päälle, ei päinvastoin.
AI Summary Helper on ilmainen Chrome-laajennus.
Lisää Chromeen