 AI Summary Helper
Vì sao chúng tôi chuyển Tìm kiếm, Gắn thẻ và Gợi ý ra khỏi đám mây
Tìm kiếm, loại bỏ trùng lặp, chuẩn hóa thẻ và gợi ý đều dùng chung một chỉ mục nhỏ ngay trên thiết bị. Dưới đây là cơ chế hoạt động, và lý do vì sao đây không đơn thuần là câu chuyện tiếp thị về quyền riêng tư.
Hầu hết các tiện ích mở rộng trình duyệt "tích hợp AI" đều gửi mọi thứ về máy chủ — bao gồm cả những phần hoàn toàn không liên quan gì đến AI. Tìm kiếm, dọn dẹp thẻ, "tìm mục tương tự": đây là những kỹ thuật đã có từ nhiều thập kỷ và được hiểu rất rõ. Chúng không cần mô hình ngôn ngữ lớn, và chắc chắn không cần độ trễ khứ hồi qua mạng. Chúng tôi đã rà soát từng tính năng của AI Summary Helper và tự đặt câu hỏi: liệu tính năng này có thực sự cần đám mây hay chúng tôi chỉ đang mặc định chọn nó vì kiến trúc đó dễ triển khai hơn?
Phần lớn trong số đó không hề cần đến.
Những gì đã thực sự được chuyển về xử lý trên thiết bị
Tìm kiếm. Ban đầu, tiện ích mở rộng chỉ đối soát trên tiêu đề và thẻ của bài viết — nhanh, nhưng không thể tìm kiếm nội dung trong thân bài. Thay vì quét toàn văn theo kiểu vét cạn mỗi khi gõ phím hoặc gửi mọi truy vấn lên máy chủ, chúng tôi đã xây dựng một chỉ mục TF-IDF nhỏ từ chính kho lưu trữ của người dùng. Các trường dữ liệu nhẹ — tiêu đề, thẻ — vẫn được kiểm tra trước tiên và tức thì như trước. Các truy vấn dài hơn sẽ được mở rộng đối soát với chỉ mục, vốn được tạo một lần mỗi phiên và cập nhật tăng dần, chứ không quét lại sau từng phím gõ.
Phát hiện trùng lặp. Trước khi quá trình lưu hoàn tất, một quy trình kiểm tra phân tầng sẽ chạy: khớp URL chuẩn hóa chính xác trước tiên (chi phí thấp, O(1)), sau đó là độ tương đồng tiêu đề trên số ít ứng viên vượt qua bộ lọc đó, và chỉ khi đó — đối với vài ứng viên còn lại — mới thực hiện so sánh độ tương đồng cosine qua TF-IDF toàn diện. Hầu hết các lượt lưu không bao giờ phải chạm tới tầng tốn kém tài nguyên nhất, vì các tầng chi phí thấp đã xử lý xong từ trước.
Chuẩn hóa thẻ. Thẻ gắn thường bị phân mảnh theo thời gian — "ML", "Machine Learning", "machine-learning" đối với con người đều mang cùng một ý nghĩa nhưng với bộ lọc lại hoàn toàn khác nhau. Một bảng bí danh (alias) nhỏ sẽ bắt các trường hợp hiển nhiên; thuật toán so khớp mờ theo khoảng cách chỉnh sửa (fuzzy edit-distance) trên toàn bộ danh mục thẻ sẽ xử lý phần còn lại, tự động chọn cách viết mà người dùng thực tế dùng nhiều nhất làm dạng chuẩn thay vì ép buộc một chuẩn máy móc.
Độ dễ đọc và giọng điệu. Thang đo cấp độ Flesch–Kincaid chỉ là phép tính số học thuần túy dựa trên số câu và số âm tiết — hoàn toàn không cần mô hình AI. Phân tích cảm xúc sử dụng danh sách từ AFINN tích hợp sẵn kèm theo kiểm tra phủ định ngắn gọn trên hai token liền trước. Cả hai tác vụ này đều không cần phải rời khỏi trình duyệt.
"Bài viết tương tự" và Bản tin tổng hợp (Digest). Cả hai đều tái sử dụng chính xác các vector TF-IDF mà tính năng tìm kiếm đã xây dựng. Sẽ rất dễ nếu cứ xây ba hệ thống tương đồng riêng biệt cho ba tính năng khác nhau. Nhưng việc xây dựng một chỉ mục duy nhất và để tìm kiếm, gợi ý và tổng hợp thông tin (digest) cùng đọc từ đó giúp tổng thể hệ thống gọn nhẹ hơn, đồng thời chỉ cần tối ưu chỉ mục một lần là cải thiện được cả ba tính năng cùng lúc.
Những gì chúng tôi chủ đích giữ lại trên đám mây
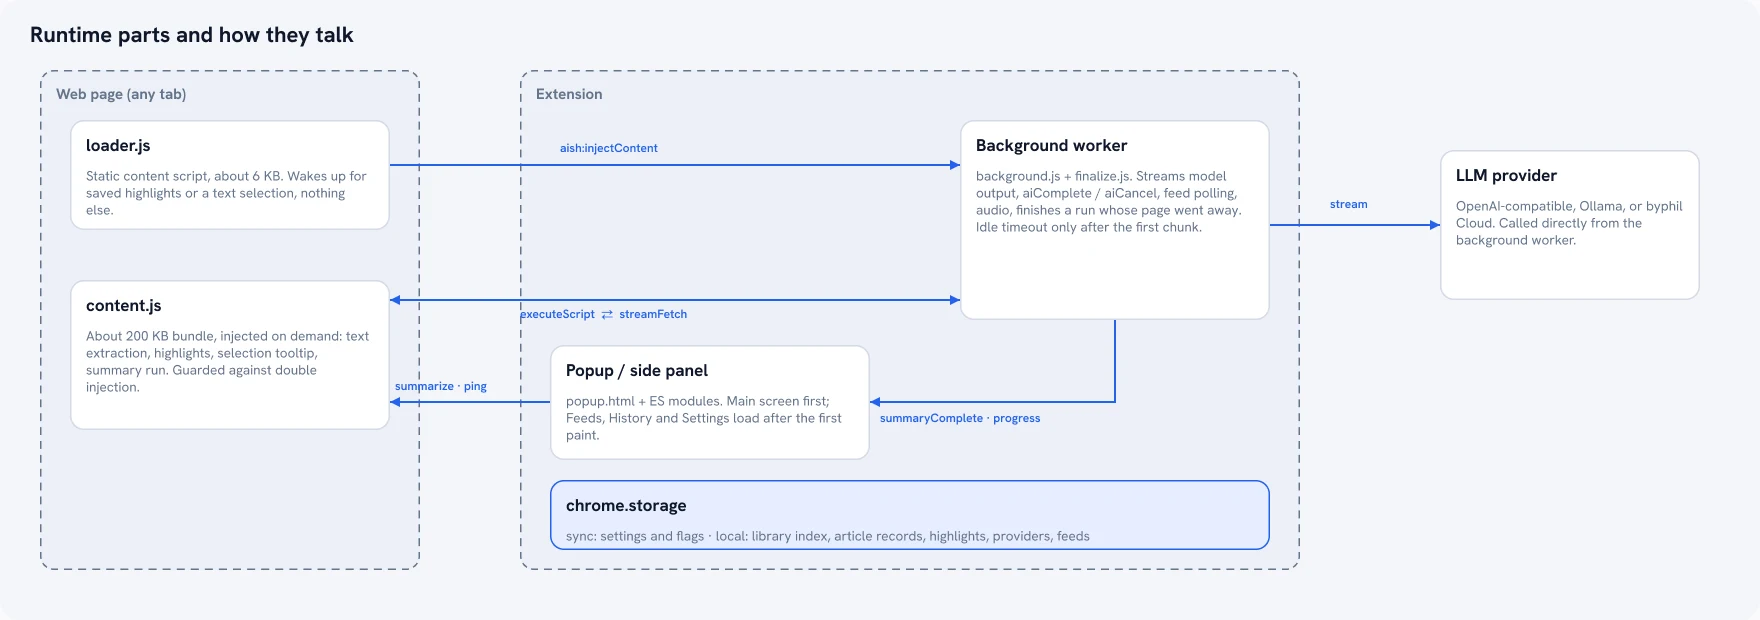
Bước tóm tắt nội dung thực tế — phần thực sự đòi hỏi một mô hình ngôn ngữ — vẫn cần đến kết nối mạng. Không thể tránh khỏi điều đó với kích thước mô hình cục bộ hiện tại nếu bạn muốn chất lượng đầu ra tương đương các mô hình hàng đầu trên đám mây. Người dùng có thể tự cung cấp API key cho bước này (OpenAI, Gemini, Mistral, DeepSeek), hoặc trỏ tiện ích mở rộng về một phiên bản Ollama cục bộ để xử lý hoàn toàn ngoại tuyến không cần mạng. Đó là điểm duy nhất mà "xử lý trên thiết bị" không phải là mặc định — mà là tùy chọn kích hoạt, vì sự đánh đổi ở đây là rõ ràng: mô hình cục bộ chạy chậm hơn và chất lượng thấp hơn mô hình máy chủ lưu trữ, và chúng tôi không muốn nói khác đi sự thật đó.
Tại sao điều này không chỉ dừng lại ở vấn đề quyền riêng tư
Góc độ quyền riêng tư là hoàn toàn xác thực — một tiện ích mở rộng có quyền truy cập máy chủ rộng rãi gửi nội dung trang web về máy chủ cho những việc không cần thiết là một vấn đề niềm tin chính đáng, chứ không chỉ là bề nổi. Nhưng lý do thực tế hơn để làm điều này là: đó đơn giản là quyết định kỹ thuật chính xác. Tìm kiếm TF-IDF không cần chịu độ trễ mạng 200ms. Loại bỏ thẻ trùng lặp không cần phải phát sinh hóa đơn API. Chọn đúng công cụ cho từng tác vụ thực tế, thay vì mặc định đẩy mọi thứ lên đám mây, sẽ tạo ra sản phẩm nhanh hơn, tiết kiệm chi phí vận hành hơn và hoạt động bền bỉ ngay cả khi ngoại tuyến (offline) — lợi ích về quyền riêng tư đương nhiên sẽ đi kèm theo đó một cách tự nhiên.
AI Summary Helper là tiện ích mở rộng miễn phí dành cho Chrome.
Thêm vào Chrome