 AI Summary Helper
Waarom we zoeken, taggen en aanbevelingen uit de cloud hebben gehaald
Zoeken, ontdubbelen, tags opschonen en aanbevelingen delen één compacte index op je eigen apparaat. Zo werkt dat, en waarom het meer is dan alleen een privacy-praatje.
De meeste browser-extensies 'met AI' sturen alles direct naar een server — zelfs de onderdelen die helemaal niets met AI te maken hebben. Zoeken, tags opschonen, 'vergelijkbare items vinden': dit zijn decennia-oude, beproefde technieken. Ze hebben geen taalmodel nodig, en zéker geen netwerkverzoek. We zijn AI Summary Helper functie voor functie nagelopen en vroegen ons telkens af: heeft dit écht de cloud nodig, of kiezen we daar alleen voor omdat het de makkelijkste architectuur is?
Het overgrote deel had het niet nodig.
Wat er nu echt lokaal op je apparaat draait
Zoeken. Oorspronkelijk matchte de extensie alleen op de titel van het artikel en tags — snel, maar blind voor de inhoud van de pagina. In plaats van de volledige tekst bij elke toetsaanslag geforceerd te scannen of elke zoekopdracht naar een server te sturen, hebben we een kleine TF-IDF-index gebouwd op basis van je eigen opgeslagen archief. Snelle velden — zoals titel en tags — worden direct als eerste gecontroleerd, net als voorheen. Langere zoekopdrachten worden breder vergeleken met de index. Die wordt eenmaal per sessie opgebouwd en stapsgewijs bijgewerkt, in plaats van opnieuw gescand bij elke toetsaanslag.
Duplicaatdetectie. Voordat een opslagactie is voltooid, draait er een gelaagde controle: eerst een exacte genormaliseerde URL-match (snel, O(1)), daarna titelovereenkomst voor het handjevol kandidaten dat door dat filter komt, en pas dan — voor de weinige overgebleven kandidaten — een volledige TF-IDF cosinus-overeenkomstvergelijking. De meeste opslagacties bereiken die zwaardere laag nooit, omdat de snelle lagen ze al hebben afgehandeld.
Tag-normalisatie. Tags gaan na verloop van tijd afwijken — "ML", "Machine Learning" en "machine-learning" betekenen voor een mens hetzelfde, maar voor een filter helemaal niets. Een kleine aliastabel vangt de duidelijke gevallen op; een fuzzy edit-distance-samenvoeging over het complete tagbestand doet de rest. Daarbij wordt de spelling gekozen die de gebruiker zelf het vaakst heeft gebruikt als de standaardvorm, in plaats van een 'correcte' vorm op te dringen.
Leesbaarheid en toon. Het Flesch–Kincaid-leesniveau is pure rekenkunde op basis van zins- en lettergreeptellingen — daar is geen enkel model voor nodig. Sentimentanalyse gebeurt via een meegeleverde AFINN-woordenlijst met een compacte ontkenningscontrole op de twee voorgaande tokens. Geen van beide hoeft je browser ooit te verlaten.
"Vergelijkbare artikelen" en Overzicht. Beide hergebruiken exact dezelfde TF-IDF-vectoren die al voor de zoekfunctie zijn opgebouwd. Het was verleidelijk geweest om drie aparte overeenkomstsystemen te bouwen voor drie verschillende functies. Door één index te bouwen waar zoeken, aanbevelingen en overzichtscuratie allemaal uit putten, blijft het hele systeem compacter en betekent een verbetering van de index direct een verbetering voor alle drie de functies tegelijk.
Wat we bewust in de cloud hebben gelaten
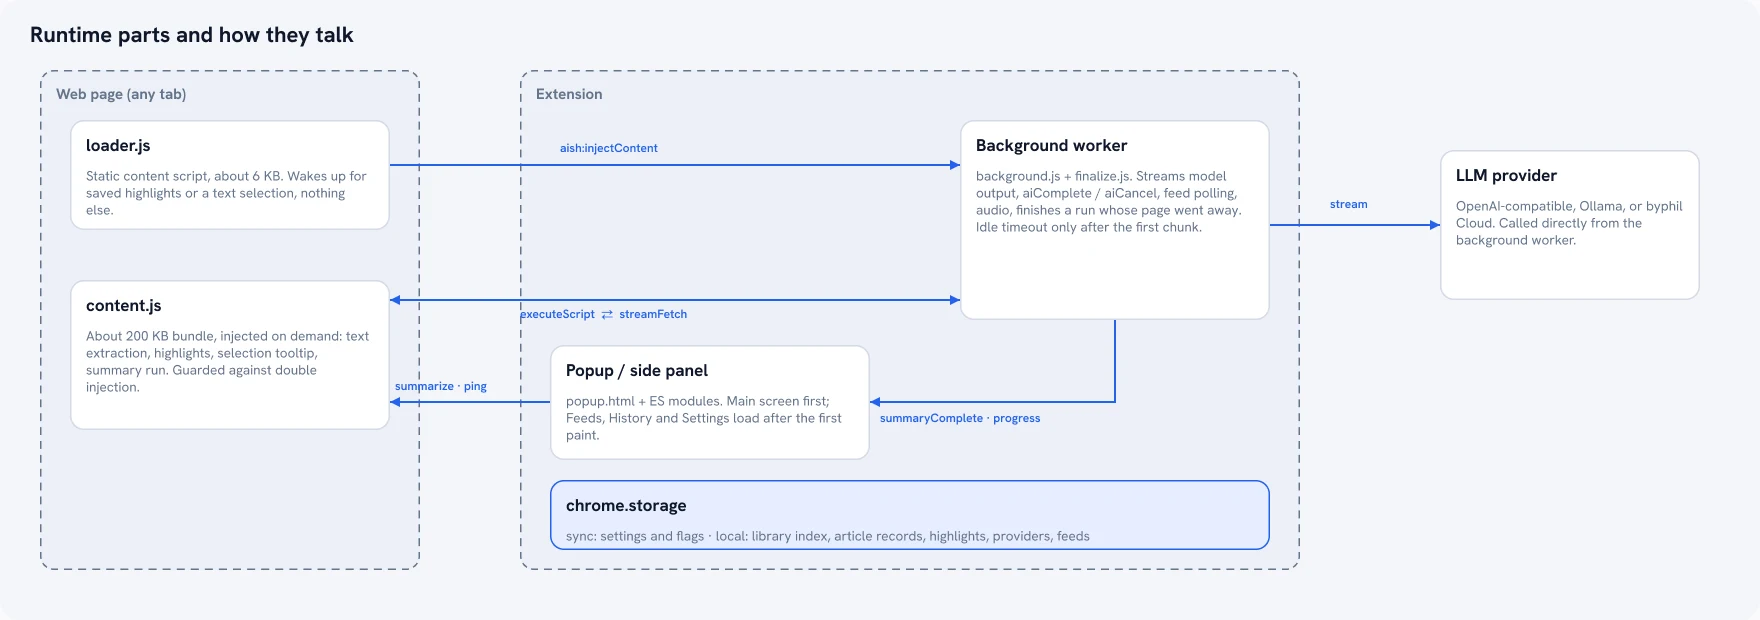
De daadwerkelijke samenvattingsstap — het deel dat écht een taalmodel vereist — vereist nog steeds een netwerkverbinding. Gezien de huidige omvang van lokale modellen ontkom je daar niet aan als je de uitvoerkwaliteit van een cloudmodel wilt. Gebruikers voeren voor die stap hun eigen API-sleutel in (OpenAI, Gemini, Mistral, DeepSeek), of koppelen de extensie aan een lokale Ollama-instantie om ook voor die stap het netwerk volledig over te slaan. Dat is de enige plek waar 'lokaal op je apparaat' niet de standaard is — het is een opt-in keuze, omdat de afweging reëel is: een lokaal model is trager en levert lagere kwaliteit dan een gehost model, en we willen daar geen doekjes om winden.
Waarom dit meer is dan een mooi privacy-verhaal
De privacy-invalshoek is reëel: een extensie met brede host-machtigingen die pagina-inhoud naar een server stuurt voor zaken die dat helemaal niet nodig hebben, roept terechte vragen op over vertrouwen — niet alleen voor de bühne of de AVG/GDPR. Maar de meer alledaagse reden hiervoor is dat het simpelweg de juiste engineeringkeuze is. TF-IDF-zoekopdrachten hebben geen 200 ms netwerklatentie nodig. Tag-ontdubbeling hoeft niet op een API-factuur te drukken. Door het juiste gereedschap voor de specifieke taak te kiezen, in plaats van standaard alles via de cloud te laten lopen, krijg je een oplossing die sneller is, goedkoper draait en prima offline werkt — het privacyvoordeel krijg je er dan gratis bij, en niet andersom.
AI Summary Helper is een gratis Chrome-extensie.
Toevoegen aan Chrome