 AI Summary Helper
Dlaczego przenieśliśmy wyszukiwanie, tagowanie i rekomendacje poza chmurę
Wyszukiwanie, deduplikacja, porządkowanie tagów i rekomendacje korzystają ze wspólnego, lekkiego indeksu lokalnego. Zobacz, jak to działa i dlaczego to coś więcej niż tylko hasło marketingowe o prywatności.
Większość rozszerzeń do przeglądarek „opartych na AI” wysyła wszystko na serwer — łącznie z funkcjami, które z AI nie mają nic wspólnego. Wyszukiwanie, porządkowanie tagów, „znajdź podobne artykuły”: to sprawdzone techniki znane od dekad. Nie potrzebują modelu językowego, a już na pewno nie wymagają zapytań sieciowych. Przeanalizowaliśmy AI Summary Helper funkcja po funkcji, zadając sobie pytanie: czy to naprawdę wymaga chmury, czy korzystamy z niej z przyzwyczajenia, bo tak było prościej?
Większość z nich wcale jej nie potrzebowała.
Co faktycznie przenieśliśmy na urządzenie
Wyszukiwanie. Początkowo rozszerzenie dopasowywało wyniki wyłącznie na podstawie tytułu artykułu i tagów — działało to szybko, ale pomijało treść artykułu. Zamiast skanować cały tekst przy każdym naciśnięciu klawisza lub wysyłać każde zapytanie na serwer, stworzyliśmy lekki indeks TF-IDF na bazie archiwum użytkownika. Proste pola — tytuł, tagi — są sprawdzane w pierwszej kolejności i natychmiast, tak jak wcześniej. Dłuższe zapytania są rozszerzane o indeks, który jest budowany raz na sesję i aktualizowany przyrostowo, bez ponownego skanowania przy każdym znaku.
Wykrywanie duplikatów. Zanim zapis zostanie ukończony, uruchamiana jest wielopoziomowa weryfikacja: najpierw dokładne dopasowanie znormalizowanego adresu URL (tanie obliczeniowo, O(1)), następnie podobieństwo tytułów dla nielicznych pasujących kandydatów, a dopiero na końcu — dla pozostałych wyjątków — pełne porównanie podobieństwa cosinusowego TF-IDF. Większość zapisów w ogóle nie dociera do najbardziej kosztownego etapu, ponieważ wcześniejsze poziomy rozwiązują sprawę od ręki.
Normalizacja tagów. Tagi z czasem ulegają rozproszeniu — „ML”, „Machine Learning”, „machine-learning” oznaczają to samo dla człowieka, ale są zupełnie różne dla filtra. Prosta tabela aliasów wyłapuje oczywiste przypadki, a resztę załatwia łączenie na podstawie odległości edycyjnej (fuzzy edit-distance) w całym słowniku tagów. Jako formę kanoniczną przyjmuje tę pisownię, której użytkownik używał najczęściej, zamiast narzucać mu „poprawną” wersję.
Czytelność i ton. Indeks czytelności Flesch–Kincaid to czysta arytmetyka oparta na liczbie zdań i sylab — nie wymaga żadnego modelu. Analiza wydźwięku opiera się na dołączonej liście słów AFINN z prostą weryfikacją negacji na dwóch poprzedzających tokenach. Żadna z tych operacji nie musi opuszczać przeglądarki.
„Podobne artykuły” i Digest. Obie funkcje korzystają z tych samych wektorów TF-IDF, które wygenerowało już wyszukiwanie. Można było łatwo stworzyć trzy oddzielne mechanizmy podobieństwa dla trzech osobnych funkcji. Zbudowanie jednego indeksu, z którego korzystają wyszukiwarka, rekomendacje i funkcja Digest, pozwoliło zachować lekkość całego systemu — a każda optymalizacja indeksu usprawnia od razu wszystkie trzy funkcje.
Co celowo zostawiliśmy w chmurze
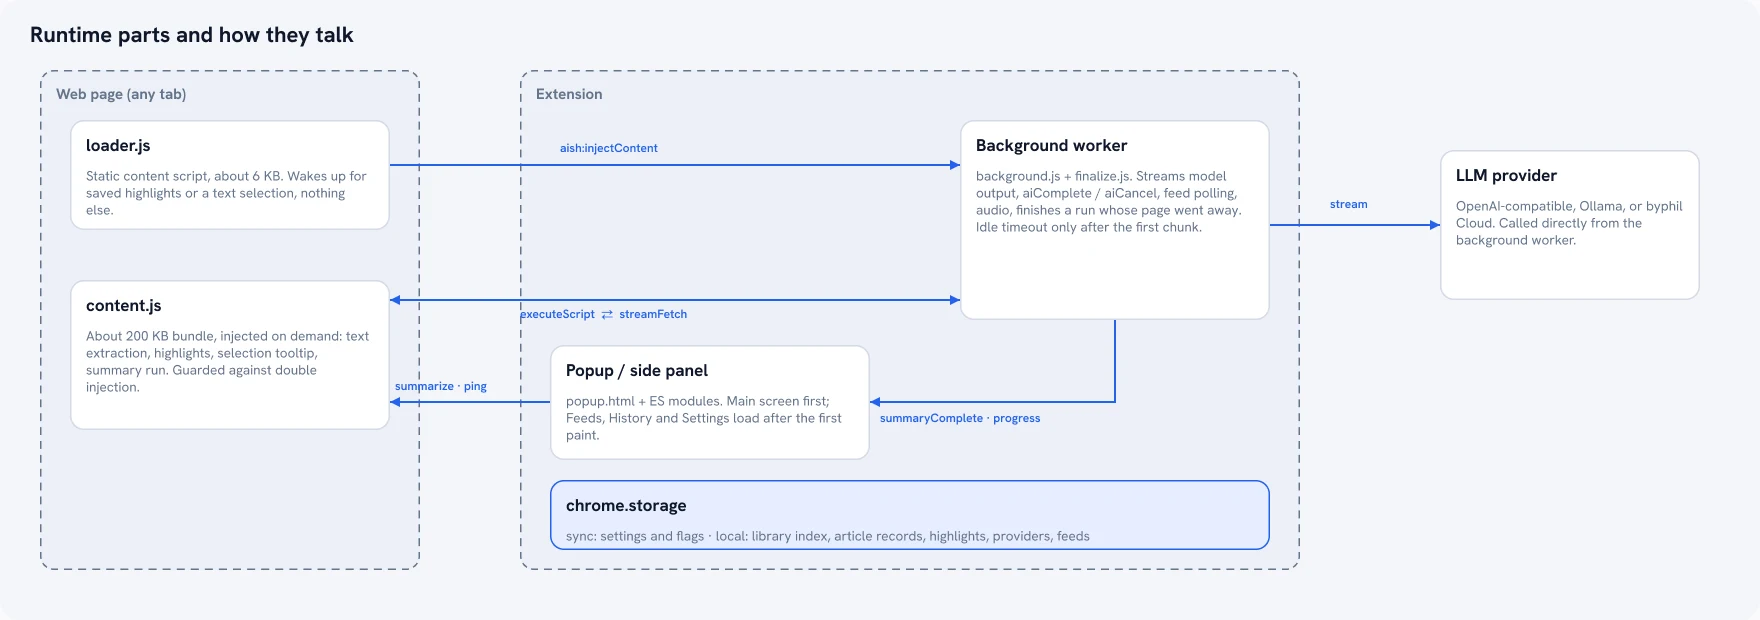
Właściwy etap podsumowywania — jedyna część, która rzeczywiście wymaga modelu językowego — nadal potrzebuje połączenia sieciowego. Przy obecnych rozmiarach modeli lokalnych nie da się tego obejść, jeśli oczekuje się jakości na poziomie modeli chmurowych. Użytkownicy mogą skorzystać z własnego klucza API (OpenAI, Gemini, Mistral, DeepSeek) w modelu bring-your-own-key lub wskazać lokalną instancję Ollama, zachowując pełną zgodność z zasadami prywatności i RODO bez wysyłania czegokolwiek do sieci. To jedyne miejsce, gdzie przetwarzanie na urządzeniu nie jest domyślne — wymaga świadomego wyboru, ponieważ kompromis jest realny: model lokalny działa wolniej i oferuje niższą jakość niż model hostowany, a my nie chcieliśmy udawać, że jest inaczej.
Dlaczego to coś więcej niż tylko kwestia prywatności
Kwestia prywatności i ochrony danych (w tym RODO) jest jak najbardziej realna — rozszerzenie o szerokich uprawnieniach, które bez potrzeby wysyła zawartość stron na serwer, słusznie rodzi pytania o zaufanie. Jednak bardziej przyziemny powód jest taki, że to po prostu dobra decyzja inżynieryjna. Wyszukiwanie TF-IDF nie potrzebuje 200 ms opóźnienia sieciowego. Deduplikacja tagów nie musi generować kosztów API. Dobieranie właściwego narzędzia do konkretnego zadania zamiast domyślnego odpytywania chmury sprawia, że rozwiązanie jest szybsze, tańsze w utrzymaniu i odporne na brak sieci — a korzyści dla prywatności otrzymujesz całkowicie przy okazji.
AI Summary Helper to bezpłatne rozszerzenie do przeglądarki Chrome.
Dodaj do Chrome