 AI Summary Helper
Почему мы перенесли поиск, тегирование и рекомендации из облака
Поиск, дедупликация, очистка тегов и рекомендации используют один компактный локальный индекс. Рассказываем, как это устроено и почему дело не только в приватности.
Большинство браузерных расширений «с поддержкой ИИ» отправляют на сервер абсолютно все данные — включая то, что к ИИ не имеет никакого отношения. Поиск, очистка тегов, поиск похожих материалов — все это десятилетиями проверенные и понятные технологии. Им не нужна языковая модель, и уж точно не требуется сетевой запрос. Мы внимательно разобрали каждую функцию AI Summary Helper и задали себе вопрос: действительно ли здесь нужно облако, или мы просто используем его по привычке, потому что так проще проектировать архитектуру?
Как оказалось, большинству функций облако не нужно.
Что именно стало работать локально
Поиск. Изначально расширение искало совпадения только по заголовку статьи и тегам — это было быстро, но содержимое текста игнорировалось. Вместо того чтобы при каждом нажатии клавиши сканировать весь текст перебором или отправлять каждый запрос на сервер, мы построили компактный индекс TF-IDF на базе вашего сохраненного архива. «Быстрые» поля — заголовок и теги — проверяются первыми и мгновенно, как и раньше. Более длинные запросы сопоставляются с индексом, который создается один раз за сессию и обновляется инкрементально, а не пересчитывается при каждом вводе символа.
Обнаружение дубликатов. Перед сохранением запускается многоуровневая проверка: сначала точное совпадение по нормализованному URL (быстро, O(1)), затем сходство заголовков для тех немногих кандидатов, которые прошли первый фильтр, и только в самом конце — для оставшихся единиц — полное сравнение косинусного сходства по TF-IDF. В большинстве случаев ресурсоемкий этап даже не запускается, так как дубликаты отсеиваются на ранних стадиях.
Нормализация тегов. Со временем в тегах возникает путаница: «ML», «Machine Learning», «machine-learning» означают одно и то же для человека, но совершенно разные вещи для фильтра. Небольшая таблица синонимов перехватывает очевидные случаи, а нечеткое объединение по расстоянию редактирования по всему словарю тегов берет на себя остальное. При этом канонической формой становится тот вариант написания, который вы использовали чаще всего, без навязывания «правильного».
Читаемость и тональность. Индекс удобочитаемости Флеша — Кинкейда — это чистая арифметика на основе подсчета предложений и слогов, модель здесь не нужна. Анализ тональности выполняется встроенным словарем AFINN с простой проверкой отрицаний по двум предшествующим токенам. Ни для того, ни для другого данные не должны покидать браузер.
«Похожие статьи» и «Дайджест». Обе функции используют ровно те же векторы TF-IDF, которые уже были построены для поиска. Можно было бы создать три отдельные системы сходства для трех разных задач. Но создание единого индекса, из которого читают поиск, рекомендации и составление дайджеста, позволило сохранить систему компактной: улучшая индекс один раз, вы сразу улучшаете все три функции.
Что мы сознательно оставили в облаке
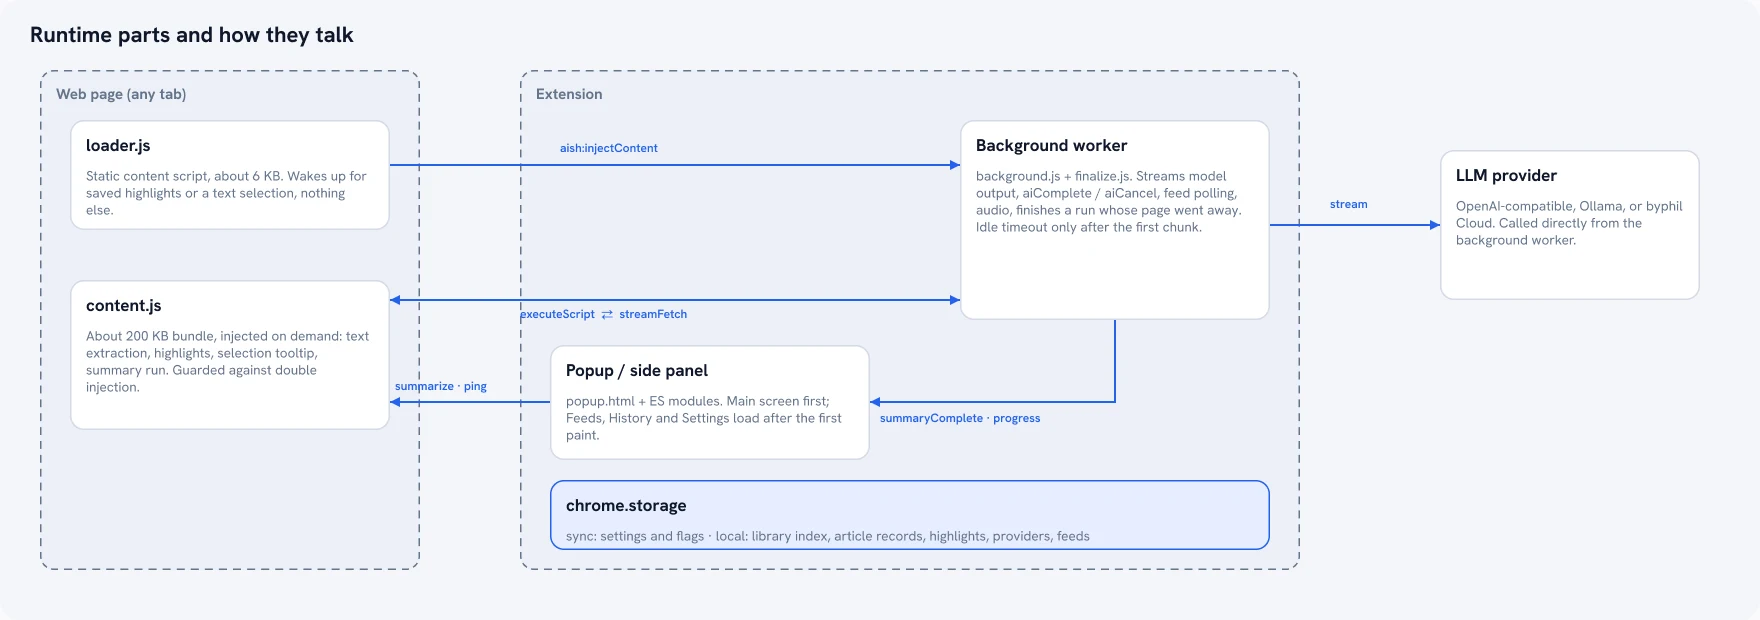
Сам этап суммаризации — та часть, которой действительно необходима языковая модель, — по-прежнему требует сетевого запроса. При текущих размерах локальных моделей это неизбежно, если вам нужно качество уровня облачных решений. Для этого шага пользователи могут подключить свой собственный API key (OpenAI, Gemini, Mistral, DeepSeek) или направить расширение на локальный экземпляр Ollama и полностью отказаться от сети даже на этом этапе. Это единственное место, где локальная работа не включена по умолчанию: здесь это осознанный выбор пользователя, ведь компромисс вполне реален — локальная модель работает медленнее и уступает по качеству облачной, и мы не хотим делать вид, что это не так.
Почему это не просто разговоры о приватности
Вопрос конфиденциальности стоит остро: расширение с широкими правами доступа, отправляющее содержимое страниц на сервер без реальной необходимости, справедливо вызывает сомнения в надежности. Но есть и более прозаическая причина: чаще всего это просто грамотное инженерное решение. Поиску на основе TF-IDF не нужны лишние 200 мс сетевой задержки. Дедупликации тегов не нужны счета за использование API. Подбор правильного инструмента под конкретную задачу вместо бездумного обращения к облаку делает систему быстрее, дешевле в поддержке и устойчивее к отсутствию сети. При этом защита приватности получается сама собой, в качестве приятного и естественного бонуса.
AI Summary Helper — бесплатное расширение для Chrome.
Установить в Chrome