 AI Summary Helper
Varför vi flyttade sök, taggning och rekommendationer bort från molnet
Sök, dubbletthantering, taggstädning och rekommendationer delar ett litet index direkt på enheten. Så fungerar det – och varför det handlar om mer än bara integritet och GDPR.
De flesta "AI-drivna" webbläsartillägg skickar allt till en server – även funktioner som inte har något med AI att göra. Sökning, tagghantering och "hitta liknande artiklar" bygger på välbeprövade tekniker sedan decennier. De kräver varken språkmodeller eller onödiga nätverksanrop. Vi gick igenom AI Summary Helper funktion för funktion och ställde oss frågan: behöver det här verkligen molnet, eller väljer vi bara det av gammal vana?
Det visade sig att det mesta inte behövde det.
Vad som faktiskt flyttades lokalt till enheten
Sökning. Från början matchade tillägget bara mot artikelns titel och taggar – snabbt, men blint för artikelns innehåll. I stället för att söka igenom all fulltext vid varje tangenttryckning eller skicka varje sökfråga till en server, byggde vi ett litet TF-IDF-index från ditt eget sparade arkiv. Snabba fält – som titel och taggar – kontrolleras först och direkt, precis som tidigare. Längre sökfrågor breddas mot indexet, som byggs en gång per session och uppdateras inkrementellt i stället för att scannas om vid varje tecken.
Identifiering av dubbletter. Innan en sida sparas körs en kontroll i flera steg: först en exakt matchning av normaliserad URL (blixtsnabb, O(1)), sedan titellikhet på de få kandidater som passerar det filtret, och först därefter – för de få som återstår – en fullständig cosinuslikhetsjämförelse med TF-IDF. De flesta sparade sidor når aldrig det tyngsta steget, eftersom de snabba kontrollerna redan löst det.
Normalisering av taggar. Taggar glider lätt isär över tid – "ML", "Machine Learning" och "machine-learning" betyder samma sak för en människa, men är helt olika för ett filter. En liten aliastabell fångar de uppenbara fallen, och en fuzzy edit-distance-sammanslagning över hela taggvokabulären löser resten. Den stavning du använt oftast väljs som standardform, i stället för att tvinga på dig en viss variant.
Läsbarhet och tonläge. Läsbarhetsindex (Flesch–Kincaid) är ren matematik baserad på antal meningar och stavelser – ingen modell behövs. Sentimentanalysen bygger på en medföljande AFINN-ordlista med en enkel negationskontroll på de två föregående orden. Inget av detta behöver lämna din webbläsare.
"Liknande artiklar" och Digest. Båda återanvänder exakt samma TF-IDF-vektorer som sökfunktionen redan har byggt upp. Det hade varit lätt att bygga tre separata likhetssystem för tre olika funktioner. Genom att bygga ett gemensamt index som sök, rekommendationer och sammanfattningsurval (digest) alla läser från, hölls systemet kompakt – och varje förbättring av indexet förbättrar alla tre funktioner samtidigt.
Vad vi medvetet lät vara kvar i molnet
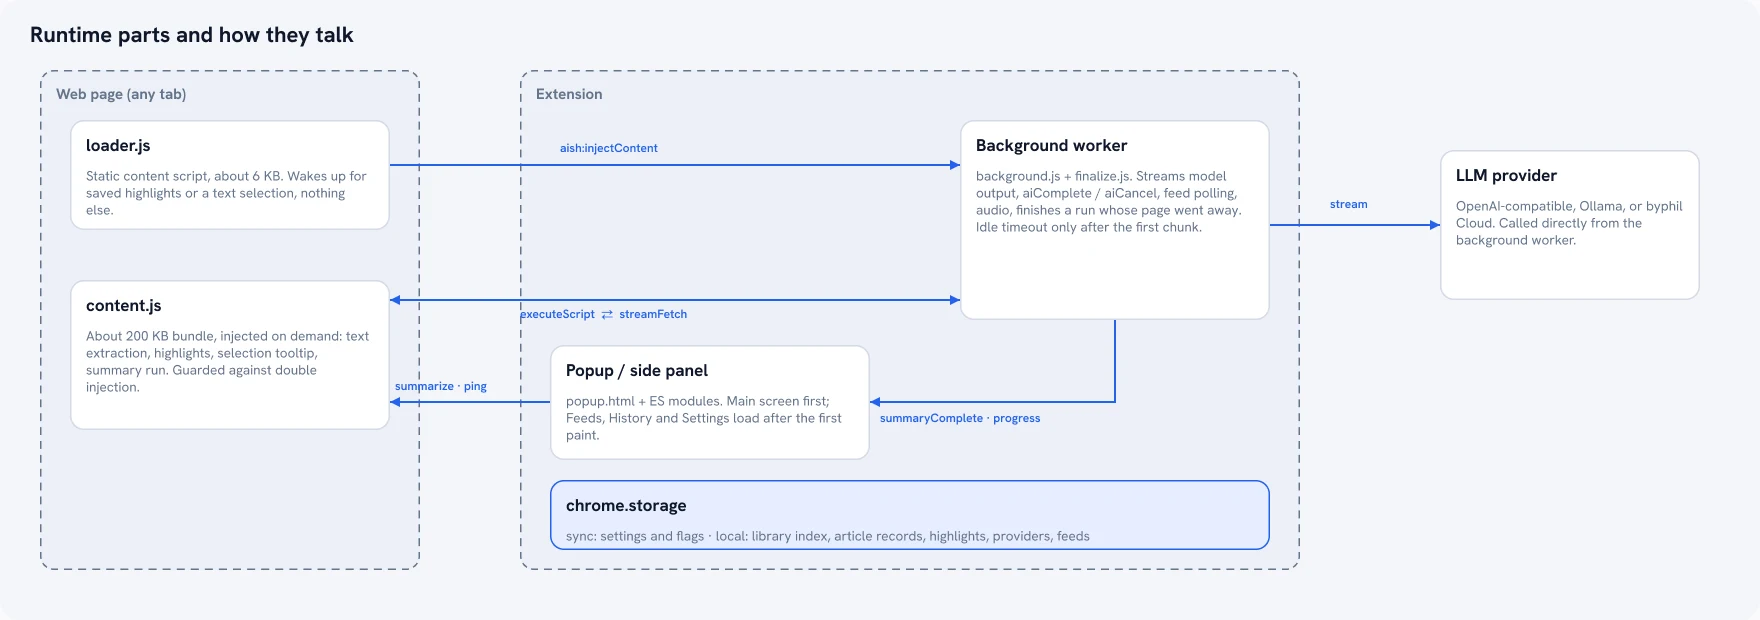
Själva sammanfattningssteget – den del som genuint kräver en språkmodell – behöver fortfarande ett nätverksanrop. Med dagens lokala modellstorlekar går det inte att komma runt om du vill ha samma kvalitet som från molnmodeller i toppklass. Här anger du din egen API key (OpenAI, Gemini, Mistral, DeepSeek), eller kopplar tillägget till en lokal Ollama-instans och slipper nätverksanrop även här. Det är den enda platsen där lokal körning inte är standard utan ett aktivt val – avvägningen är reell: en lokal modell är långsammare och har lägre kvalitet än en hostad modell, och vi ville inte låtsas om något annat.
Varför detta är mer än bara ett argument för integritet och GDPR
Integritetsaspekten är högst reell – ett webbläsartillägg med breda behörigheter som skickar sidinnehåll till en server för saker som inte kräver det väcker berättigade frågor om förtroende och dataskydd. Men det mer vardagliga skälet är att det helt enkelt är bättre ingenjörskonst. TF-IDF-sökning behöver inte 200 ms nätverkslatens. Taggstädning behöver inte kosta API-avgifter. När man väljer rätt verktyg för jobbet i stället för att slentrianmässigt anropa molnet blir resultatet snabbare, billigare att drifta och mer tåligt offline – den förbättrade integriteten får du på köpet, inte tvärtom.
AI Summary Helper är ett gratis tillägg för Chrome.
Lägg till i Chrome