 AI Summary Helper
ทำไมเราถึงย้ายระบบค้นหา แท็ก และการแนะนำเนื้อหาออกจากคลาวด์
ระบบค้นหา ตรวจจับเนื้อหาซ้ำ จัดการแท็ก และแนะนำเนื้อหา ทั้งหมดทำงานร่วมกันบนดัชนีขนาดเล็กภายในอุปกรณ์ มาดูกลไกการทำงานและเหตุผลที่สิ่งนี้ไม่ใช่แค่เรื่องความเป็นส่วนตัวเท่านั้น
ส่วนขยายเบราว์เซอร์ที่เคลมว่า "ขับเคลื่อนด้วย AI" ส่วนใหญ่มักส่งข้อมูลทุกอย่างไปยังเซิร์ฟเวอร์ แม้แต่ส่วนที่ไม่ได้เกี่ยวข้องกับ AI เลยก็ตาม ไม่ว่าจะเป็นการค้นหา การจัดระเบียบแท็ก หรือ "การค้นหาเนื้อหาที่คล้ายกัน" เทคนิคเหล่านี้มีมานานหลายทศวรรษและเข้าใจได้ง่าย จึงไม่จำเป็นต้องใช้โมเดลภาษาขนาดใหญ่ และไม่จำเป็นต้องส่งข้อมูลข้ามเครือข่ายไปมา เราได้ทบทวนฟีเจอร์ต่างๆ ของ AI Summary Helper ทีละรายการพร้อมตั้งคำถามว่า ฟีเจอร์นี้จำเป็นต้องพึ่งคลาวด์จริงหรือไม่ หรือเราแค่เลือกใช้เพราะเป็นสถาปัตยกรรมที่ง่ายที่สุด?
และคำตอบคือ ฟีเจอร์ส่วนใหญ่ไม่จำเป็นต้องใช้คลาวด์เลย
สิ่งที่เราย้ายมาประมวลผลบนอุปกรณ์
ระบบค้นหา เดิมที ส่วนขยายนี้ค้นหาและจับคู่เฉพาะชื่อบทความและแท็ก ซึ่งทำงานได้รวดเร็วแต่ไม่สามารถตรวจหาเนื้อหาในบทความได้ แทนที่จะใช้วิธีสแกนข้อความทั้งหมดแบบ Brute-force ทุกครั้งที่พิมพ์ หรือส่งคำค้นหาไปยังเซิร์ฟเวอร์ เราได้สร้างดัชนี TF-IDF ขนาดเล็กจากคลังข้อมูลที่บันทึกไว้ในเครื่อง ฟิลด์ที่ประมวลผลได้เร็วอย่างชื่อบทความและแท็กจะถูกตรวจสอบก่อนแบบทันทีเช่นเดิม ส่วนคำค้นหาที่ยาวขึ้นจะค้นหาเทียบกับดัชนีที่สร้างขึ้นเพียงครั้งเดียวต่อเซสชันและอัปเดตแบบเพิ่มหน่วยย่อย (incremental) โดยไม่ต้องสแกนใหม่ทุกครั้งที่กดแป้นพิมพ์
การตรวจจับเนื้อหาซ้ำ ก่อนการบันทึกจะเสร็จสมบูรณ์ ระบบจะตรวจสอบแบบเป็นลำดับขั้น: เริ่มจากจับคู่ URL ที่แปลงเป็นรูปแบบมาตรฐานแล้ว (ประมวลผลเร็ว, O(1)) จากนั้นตรวจสอบความคล้ายคลึงของชื่อบทความเฉพาะรายการที่ผ่านการกรองขั้นแรก และเฉพาะรายการที่เหลือไม่กี่รายการเท่านั้นที่จะถูกนำมาเปรียบเทียบความคล้ายคลึงแบบ TF-IDF Cosine Similarity เต็มรูปแบบ การบันทึกส่วนใหญ่จึงแทบไม่ต้องประมวลผลขั้นสูงเลย เพราะจัดการเสร็จสิ้นได้ตั้งแต่ขั้นแรกแล้ว
การจัดรูปแบบแท็กให้เป็นมาตรฐาน แท็กมักมีความคลาดเคลื่อนสะสมตามกาลเวลา เช่น "ML", "Machine Learning", "machine-learning" ซึ่งสื่อถึงสิ่งเดียวกันสำหรับมนุษย์ แต่ระบบตัวกรองมองว่าแตกต่างกัน ตารางนามแฝง (alias table) ขนาดเล็กจะช่วยตรวจจับกรณีที่เห็นได้ชัด ส่วนการผสานคำด้วย Fuzzy Edit-distance ทั่วทั้งคลังแท็กจะช่วยจัดการส่วนที่เหลือ โดยเลือกการสะกดที่ใช้งานบ่อยที่สุดเป็นรูปแบบหลัก แทนที่จะบังคับเปลี่ยนเป็นรูปแบบที่กำหนดไว้
ระดับความง่ายในการอ่านและโทนเสียง ระดับความยากง่ายในการอ่านแบบ Flesch–Kincaid เป็นเพียงการคำนวณทางคณิตศาสตร์จากจำนวนประโยคและพยางค์ จึงไม่จำเป็นต้องใช้โมเดลใดๆ ส่วนการวิเคราะห์ความรู้สึก (Sentiment) ใช้รายการคำศัพท์ AFINN ภายในเครื่อง พร้อมการตรวจสอบคำปฏิเสธจาก 2 โทเค็นก่อนหน้า ทั้งหมดนี้จึงทำงานได้ภายในเบราว์เซอร์โดยไม่ต้องส่งข้อมูลออกไปภายนอก
"บทความที่คล้ายกัน" และ Digest ทั้งสองฟีเจอร์นี้ใช้เวกเตอร์ TF-IDF เดียวกันกับที่ระบบค้นหาสร้างไว้ แม้การสร้างระบบเปรียบเทียบความคล้ายคลึงแยกกัน 3 ระบบสำหรับ 3 ฟีเจอร์จะเป็นเรื่องง่าย แต่การสร้างดัชนีเดียวแล้วให้ระบบค้นหา ระบบแนะนำเนื้อหา และการคัดสรร Digest ใช้งานร่วมกัน ช่วยให้ระบบโดยรวมมีขนาดกะทัดรัด และเมื่อปรับปรุงดัชนีเพียงครั้งเดียว ก็ช่วยเพิ่มประสิทธิภาพของทั้ง 3 ฟีเจอร์ได้พร้อมกัน
สิ่งที่เราตั้งใจคงไว้บนคลาวด์
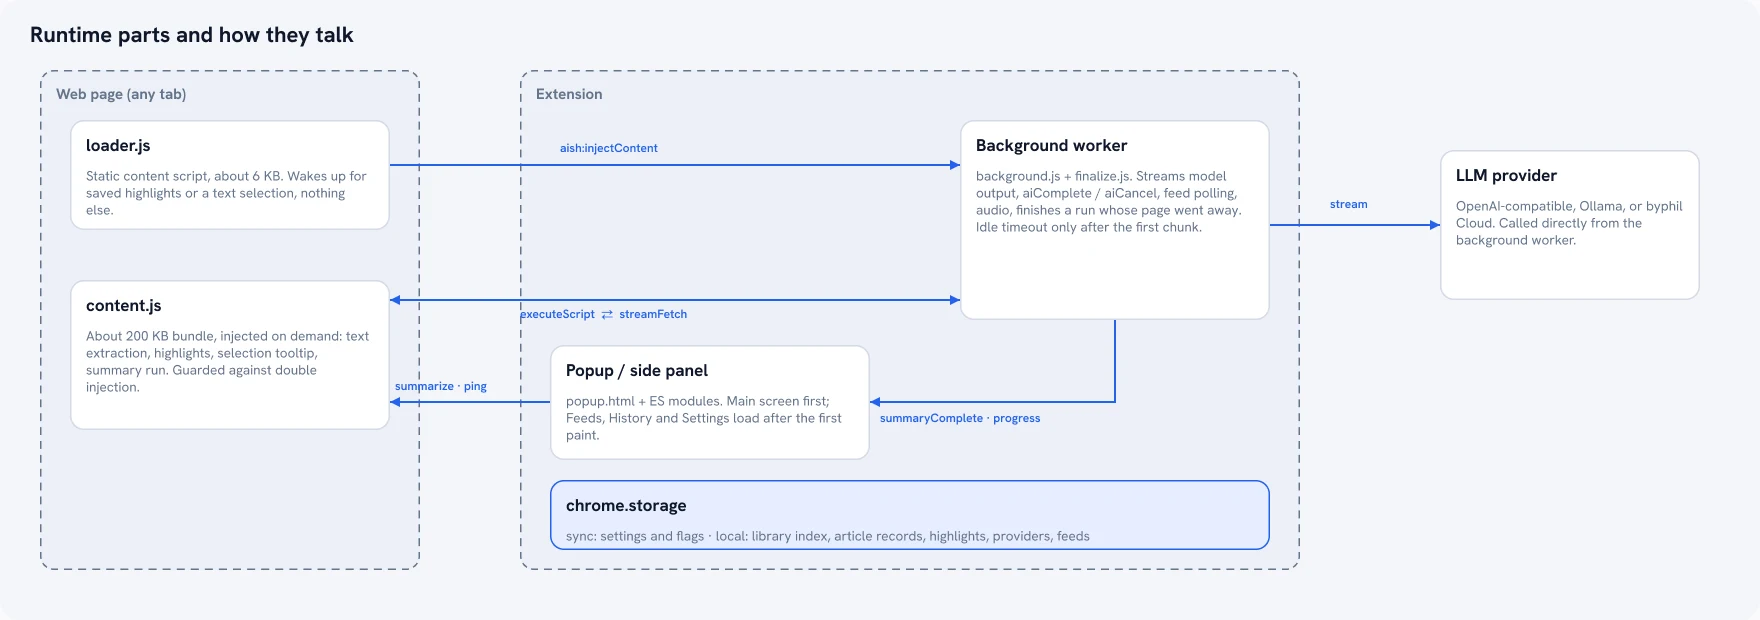
ขั้นตอนการสรุปเนื้อหาจริง ซึ่งเป็นส่วนที่ต้องพึ่งพาโมเดลภาษาขนาดใหญ่อย่างแท้จริง ยังคงต้องเชื่อมต่อผ่านเครือข่าย เนื่องจากขนาดของโมเดลบนอุปกรณ์ในปัจจุบันยังไม่สามารถเทียบเท่าคุณภาพระดับโมเดลบนคลาวด์ได้ ผู้ใช้สามารถนำ API key ของตนเองมาใช้ในขั้นตอนนี้ (เช่น OpenAI, Gemini, Mistral, DeepSeek) หรือจะเลือกเชื่อมต่อส่วนขยายกับ Ollama ภายในเครื่องเพื่อทำงานแบบออฟไลน์โดยไม่ต้องเชื่อมต่อเครือข่ายก็ได้เช่นกัน นี่จึงเป็นจุดเดียวที่ไม่ได้ตั้งค่าการทำงานบนอุปกรณ์ไว้เป็นค่าเริ่มต้น แต่เปิดให้เลือกใช้งานตามความต้องการ เพราะมีข้อจำกัดที่ต้องแลกเปลี่ยน: โมเดลในเครื่องอาจประมวลผลช้ากว่าและให้คุณภาพต่ำกว่าโมเดลบนคลาวด์
ทำไมเรื่องนี้จึงมีคุณค่ามากกว่าแค่ประเด็นความเป็นส่วนตัว
มิติด้านความเป็นส่วนตัวนั้นสำคัญอย่างยิ่ง การที่ส่วนขยายซึ่งมีสิทธิ์การเข้าถึงระดับกว้างส่งเนื้อหาของหน้าเว็บไปยังเซิร์ฟเวอร์โดยไม่จำเป็น ถือเป็นคำถามเรื่องความไว้วางใจอย่างแท้จริง ไม่ใช่แค่เรื่องภาพลักษณ์ แต่เหตุผลพื้นฐานที่สำคัญยิ่งกว่าคือ นี่คือการตัดสินใจทางวิศวกรรมที่ถูกต้อง การค้นหาด้วย TF-IDF ไม่จำเป็นต้องเสียเวลา Latency บนเครือข่าย 200ms การตัดแท็กซ้ำไม่ควรมีค่าใช้จ่าย API พ่วงมา การเลือกเครื่องมือให้ตรงกับลักษณะงาน แทนที่จะส่งทุกอย่างไปประมวลผลบนคลาวด์ ช่วยให้ระบบทำงานได้รวดเร็วกว่า ประหยัดต้นทุนกว่า และรองรับการทำงานแบบออฟไลน์ได้อย่างเสถียร โดยมีข้อดีด้านความเป็นส่วนตัวเป็นผลพลอยได้ที่ตามมาทันที
AI Summary Helper เป็นส่วนขยาย Chrome ที่ใช้งานได้ฟรี
เพิ่มลงใน Chrome