 AI Summary Helper
Arama, Etiketleme ve Önerileri Neden Buluttan Cihaza Taşıdık?
Arama, mükerrer kayıt temizleme, etiket düzenleme ve öneriler tek bir küçük on-device dizini paylaşıyor. Bunun nasıl çalıştığını ve neden sadece bir gizlilik argümanından ibaret olmadığını keşfedin.
"Yapay zeka destekli" çoğu tarayıcı eklentisi, yapay zekayla uzaktan yakından ilgisi olmayan kısımlar da dahil olmak üzere her şeyi bir sunucuya gönderir. Arama, etiket temizleme, "benzer öğeleri bulma": bunlar onlarca yıllık, son derece iyi bilinen tekniklerdir. Bir dil modeline ihtiyaç duymazlar ve kesinlikle fazladan bir network gidiş-dönüşüne (round-trip) gereksinimleri yoktur. AI Summary Helper'ın tüm özelliklerini tek tek ele alarak her biri için şu soruyu sorduk: Bunun gerçekten buluta ihtiyacı var mı, yoksa sırf mimari açıdan kolayı bu olduğu için mi varsayılan olarak bulutu seçiyoruz?
Çoğunun buna hiç ihtiyacı yoktu.
Cihaza (on-device) taşınan özellikler
Arama. Eklenti başlangıçta yalnızca makale başlığı ve etiketlerle eşleşiyordu — bu hızlıydı ancak makale gövdesinde olan bitene karşı tamamen kördü. Her tuş vuruşunda tüm metni kaba kuvvetle (brute-force) taramak ya da her sorguyu sunucuya göndermek yerine, kullanıcının kendi kayıtlı arşivinden küçük bir TF-IDF dizini oluşturduk. Başlık ve etiketler gibi az maliyetli alanlar, tıpkı eskisi gibi ilk önce ve anında kontrol ediliyor. Daha uzun sorgular ise her tuş vuruşunda yeniden taranmak yerine, oturum başına bir kez oluşturulan ve kademeli olarak güncellenen dizin üzerinden genişletiliyor.
Mükerrer içerik tespiti. Kaydetme işlemi tamamlanmadan önce kademeli bir kontrol çalışır: önce tam normalize edilmiş URL eşleşmesi (düşük maliyetli, O(1)), ardından bu filtreyi geçen az sayıdaki aday üzerinde başlık benzerliği ve yalnızca geriye kalan birkaç aday için tam bir TF-IDF kosinüs benzerliği (cosine-similarity) karşılaştırması. Kayıtların çoğu yüksek maliyetli aşamaya hiç ulaşmaz, çünkü düşük maliyetli aşamalar durumu zaten çözmüştür.
Etiket normalizasyonu. Etiketler zamanla farklılaşır — "ML", "Machine Learning" ve "machine-learning" bir insan için aynı anlama gelirken bir filtre için tamamen farklıdır. Küçük bir alias tablosu bariz durumları yakalar; tüm etiket dağarcığı genelinde yapılan bir fuzzy edit-distance birleştirmesi ise geri kalanını toparlar. Kullanıcıya zorla "doğru" bir yazım dayatmak yerine, pratikte en sık kullandığı yazımı standart biçim olarak kabul eder.
Okunabilirlik ve ton. Flesch–Kincaid okunabilirlik seviyesi, cümle ve hece sayıları üzerinden yapılan saf bir aritmetikten ibarettir — model gerektirmez. Duygu analizi ise önceki iki belirteç (token) üzerinde küçük bir olumsuzluk kontrolü yapan, pakete dahil edilmiş bir AFINN kelime listesidir. Bunların hiçbirinin tarayıcı dışına çıkması gerekmiyordu.
"Benzer makaleler" ve Digest. Her iki özellik de aramanın halihazırda oluşturduğu TF-IDF vektörlerini doğrudan yeniden kullanır. Üç ayrı özellik için üç ayrı benzerlik sistemi kurmak kolay olabilirdi. Ancak tek bir dizin oluşturup arama, öneriler ve özet bülteni kürasyonunun hepsinin bu dizinden beslenmesini sağlamak, toplam sistemi daha kompakt tuttu. Ayrıca dizini bir kez iyileştirmenin her üç özelliği de aynı anda geliştirmesini sağladı.
Bilinçli olarak bulutta bıraktığımız kısım
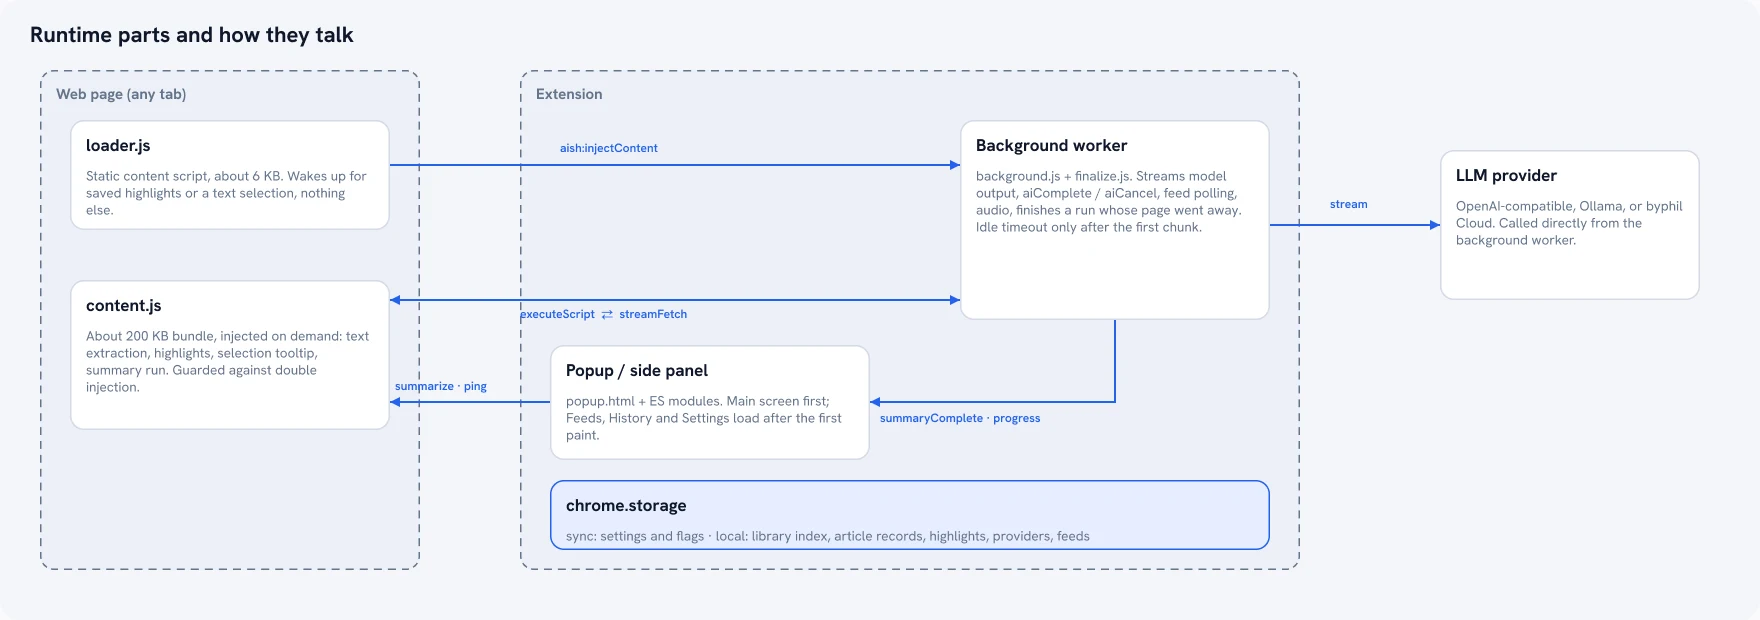
Gerçek özetleme adımı — yani hakikaten bir dil modeli gerektiren kısım — halen bir network çağrısına ihtiyaç duyar. Bulut düzeyindeki bir modelin çıktı kalitesini hedefliyorsanız, mevcut on-device model boyutlarıyla bunun önüne geçmek mümkün değildir. Kullanıcılar bu adım için kendi API anahtarlarını (BYOK: OpenAI, Gemini, Mistral, DeepSeek) getirir veya eklentiyi yerel bir Ollama kurulumuna yönlendirerek bu adımda da ağ bağlantısını tamamen devre dışı bırakabilir. "On-device" yaklaşımının varsayılan olmadığı tek nokta burasıdır — tercihe bağlıdır; çünkü buradaki ödünleşim gerçektir: Yerel bir model, barındırılan bir modele göre daha yavaştır ve daha düşük kalite sunar, aksini iddia etmek istemedik.
Bu neden sadece bir gizlilik argümanından ibaret değil?
Gizlilik boyutu son derece gerçektir — geniş host izinlerine sahip bir eklentinin, buna gerek duymayan işlemler için sayfa içeriğini sunucuya göndermesi yalnızca bir imaj meselesi değil, meşru bir güven konusudur. Ancak bunu yapmanın daha yalın sebebi, mühendislik açısından genellikle en doğru karar olmasıdır. TF-IDF aramasının 200 ms'lik bir network latency değerine ihtiyacı yoktur. Etiket tekilleştirmenin bir API faturası yaratmasına gerek yoktur. Her şeyi varsayılan olarak "buluta gönder" yaklaşımıyla çözmek yerine, aracı doğrudan ihtiyaca göre seçmek genellikle daha hızlı, işletmesi daha ucuz ve çevrimdışı çalışmaya daha dayanıklı çözümler üretir — gizlilik avantajı ise bu kararın doğal bir getirisi olur, tersi değil.
AI Summary Helper, ücretsiz bir Chrome uzantısıdır.
Chrome'a ekle