 AI Summary Helper
Чому ми перенесли пошук, тегування та рекомендації з хмари на пристрій
Пошук, дедуплікація, очищення тегів і рекомендації використовують один невеликий локальний індекс. Розповідаємо, як це працює і чому це не просто маркетингові розмови про приватність.
Більшість розширень для браузера «на базі ШІ» відправляють на сервер геть усе — навіть те, що не має до ШІ жодного стосунку. Пошук, очищення тегів, «знайти схоже»: усім цим надійним методам уже десятки років. Їм не потрібна мовна модель і тим паче не потрібні зайві мережеві запити. Ми переглянули кожну функцію AI Summary Helper і запитали себе: чи справді тут потрібна хмара, чи ми використовуємо її лише за звичкою, бо так простіше розробляти?
Виявилося, що для більшості функцій хмара не потрібна.
Що ми насправді перенесли на пристрій
Пошук. Спочатку розширення шукало збіги лише в назвах статей і тегах — це швидко, але не враховує вміст самої статті. Замість сканування всього тексту «в лоб» при кожному натисканні клавіші чи відправки кожного запиту на сервер, ми створили невеликий індекс TF-IDF на основі вашого збереженого архіву. «Дешеві» поля (назва, теги) перевіряються першими й миттєво, як і раніше. Довші запити звіряються з індексом, який формується раз на сесію та оновлюється інкрементно, без повторного пересканування тексту з кожною літерою.
Виявлення дублікатів. Перед збереженням виконується багаторівнева перевірка: спершу точний збіг нормалізованого URL (швидко, O(1)), потім схожість назв серед небагатьох кандидатів після першого фільтра, і лише тоді — для решти варіантів — повне порівняння косинусної схожості через TF-IDF. Більшість збережень навіть не доходять до ресурсомісткого етапу, оскільки швидкі перевірки відсіюють усе зайве раніше.
Нормалізація тегів. З часом теги розмиваються: «ML», «Machine Learning», «machine-learning» означають одне й те саме для людини, але є абсолютно різними для фільтра. Невелика таблиця аліасів розпізнає очевидні випадки, а нечітке об'єднання за відстанню редагування по всьому словнику тегів підхоплює решту. Система обирає як канонічний той варіант написання, який ви насправді використовували найчастіше, а не нав'язує свій «правильний».
Читабельність і тональність. Індекс читабельності Флеша–Кінкейда — це чиста арифметика на основі кількості речень і складів, модель для цього не потрібна. Аналіз тональності спирається на вбудований словник слів AFINN із невеликою перевіркою заперечень у двох попередніх токенах. Жодному з цих процесів не потрібно виходити за межі браузера.
«Схожі статті» та Дайджест. Обидва інструменти повторно використовують ті самі вектори TF-IDF, які вже створив пошук. Можна було б легко створити три окремі системи подібності для трьох окремих функцій. Проте створення єдиного індексу, до якого звертаються пошук, рекомендації та формування дайджесту, зробило систему компактнішою: поліпшення індексу один раз автоматично вдосконалює всі три функції.
Що ми свідомо залишили в хмарі
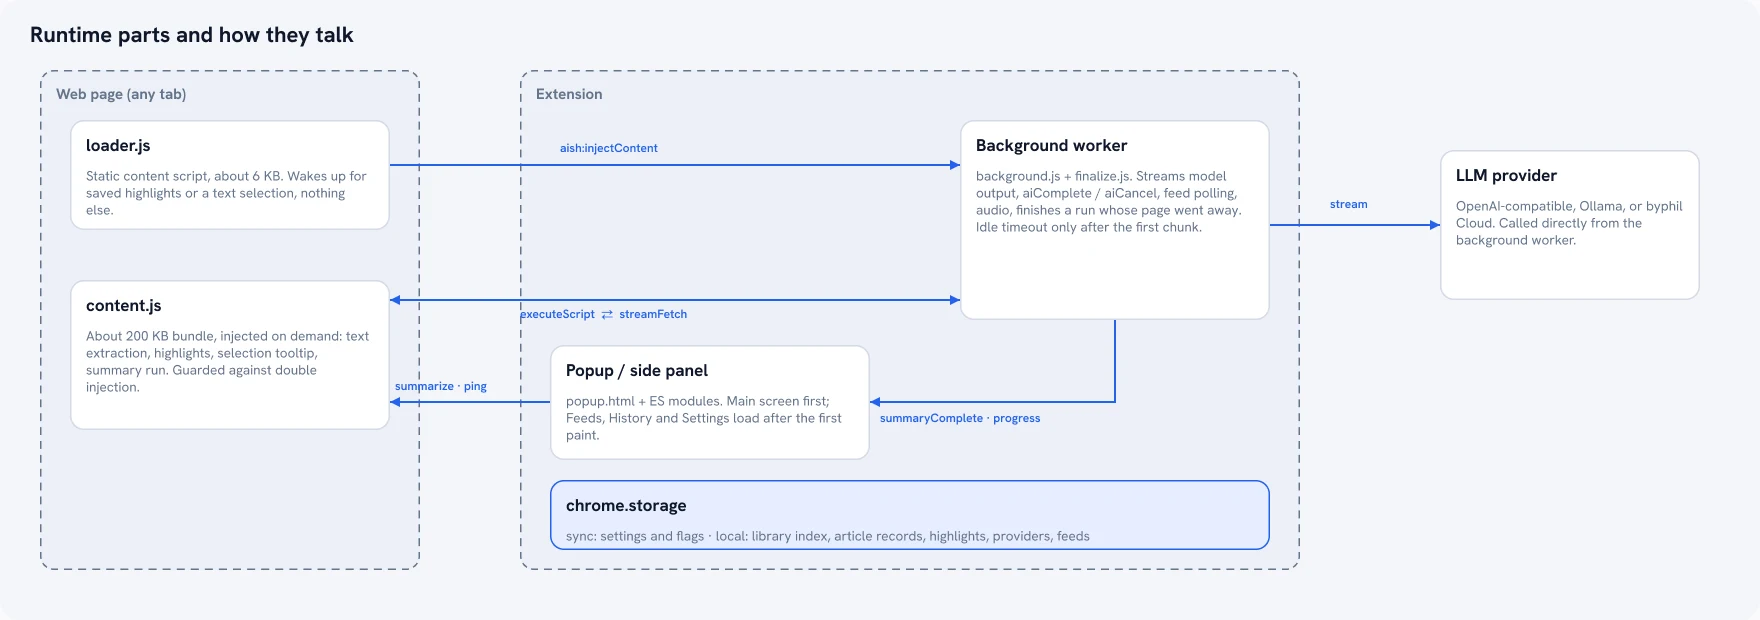
Сам крок підсумовування — єдина частина, яка дійсно потребує великої мовної моделі — усе ще виконується через мережу. З поточними розмірами локальних моделей цього не уникнути, якщо вам потрібна якість відповідей рівня провідних хмарних систем. Ви можете використовувати власний API key (OpenAI, Gemini, Mistral, DeepSeek) або підключити розширення до локального інстансу Ollama й повністю відмовитися від мережі навіть для цього кроку. Це єдине місце, де робота «на пристрої» не встановлена за замовчуванням: це опція на вибір, адже тут є реальний компроміс. Локальна модель працює повільніше та поступається якістю хмарній, і ми не хочемо цього приховувати.
Чому це більше, ніж просто розмови про приватність
Питання приватності дійсно важливе: коли розширення із широкими дозволами надсилає вміст сторінок на сервер для речей, які цього не потребують, виникають обґрунтовані сумніви щодо довіри. Але простіша причина такого рішення — це звичайна інженерна доцільність. Пошуку через TF-IDF не потрібні 200 мс мережевої затримки. Дедуплікація тегів не повинна додавати витрат на API. Коли інструмент підбирається під конкретне завдання, а не все поспіль скеровується в хмару за замовчуванням, продукт працює швидше, коштує дешевше і залишається стійким до роботи офлайн. А приватність стає приємним і безкоштовним бонусом, а не самоціллю.
AI Summary Helper — це безкоштовне розширення для Chrome.
Додати в Chrome