 AI Summary Helper
Alasan Kami Memindahkan Pencarian, Penandaan Tag, dan Rekomendasi Keluar dari Cloud
Pencarian, dedup, pembersihan tag, dan rekomendasi berbagi satu indeks on-device yang ringan. Begini cara kerjanya, dan mengapa ini bukan sekadar gimik privasi.
Sebagian besar ekstensi browser "bertenaga AI" mengirimkan semuanya ke server — termasuk bagian yang sama sekali tidak berhubungan dengan AI. Pencarian, pembersihan tag, "temukan item serupa": ini adalah teknik berusia puluhan tahun yang sudah teruji. Teknik ini tidak memerlukan language model, dan jelas tidak butuh latensi bolak-balik jaringan. Kami meninjau fitur AI Summary Helper satu per satu dan bertanya: apakah ini benar-benar membutuhkan cloud, atau kita hanya menjadikannya default karena arsitekturnya yang paling gampang?
Sebagian besar ternyata tidak membutuhkannya.
Apa saja yang benar-benar dipindahkan ke on-device
Pencarian. Awalnya, ekstensi ini hanya mencocokkan judul artikel dan tag — cepat, tetapi mengabaikan isi artikel. Daripada memindai teks lengkap secara brute-force di setiap ketukan tombol atau mengirim setiap kueri ke server, kami membangun indeks TF-IDF kecil dari arsip simpanan milik pengguna sendiri. Kolom ringan — judul, tag — diperiksa terlebih dahulu secara instan seperti sebelumnya. Kueri yang lebih panjang diperluas terhadap indeks, yang dibuat sekali per sesi dan diperbarui secara inkremental, bukan dipindai ulang di setiap ketukan.
Deteksi duplikat. Sebelum penyimpanan selesai, pemeriksaan bertingkat dijalankan: pencocokan URL ternormalisasi yang persis terlebih dahulu (ringan, O(1)), lalu kemiripan judul pada beberapa kandidat yang lolos filter tersebut, dan baru kemudian — untuk sedikit kandidat yang tersisa — perbandingan cosine similarity TF-IDF lengkap. Sebagian besar simpanan tidak pernah mencapai tahap yang berat sama sekali, karena tahap yang ringan sudah menyelesaikannya.
Normalisasi tag. Tag kerap mengalami variasi penulisan seiring waktu — "ML", "Machine Learning", "machine-learning" semuanya bermakna sama bagi manusia, namun dianggap berbeda oleh filter. Tabel alias kecil menangani kasus-kasus yang jelas; penggabungan fuzzy edit-distance di seluruh kosakata tag menangani sisanya, memilih ejaan mana pun yang paling sering digunakan pengguna sebagai bentuk kanonikal daripada memaksakan bentuk "yang benar" kepada Anda.
Keterbacaan dan nada bicara. Tingkat keterbacaan Flesch–Kincaid murni aritmatika pada jumlah kalimat dan suku kata — tidak memerlukan model AI. Sentimen menggunakan daftar kata AFINN bawaan dengan pemeriksaan negasi sederhana pada dua token sebelumnya. Keduanya sama sekali tidak perlu keluar dari browser.
"Artikel serupa" dan Digest. Keduanya menggunakan kembali vektor TF-IDF yang sama persis yang telah dibangun oleh fitur pencarian. Sebenarnya mudah saja membangun tiga sistem kemiripan terpisah untuk tiga fitur berbeda. Namun, membangun satu indeks dan membiarkan pencarian, rekomendasi, serta kurasi ringkasan membaca dari indeks tersebut membuat sistem secara keseluruhan lebih ramping, dan mengoptimalkan indeks satu kali berarti meningkatkan ketiga fitur sekaligus.
Apa yang sengaja kami biarkan tetap di cloud
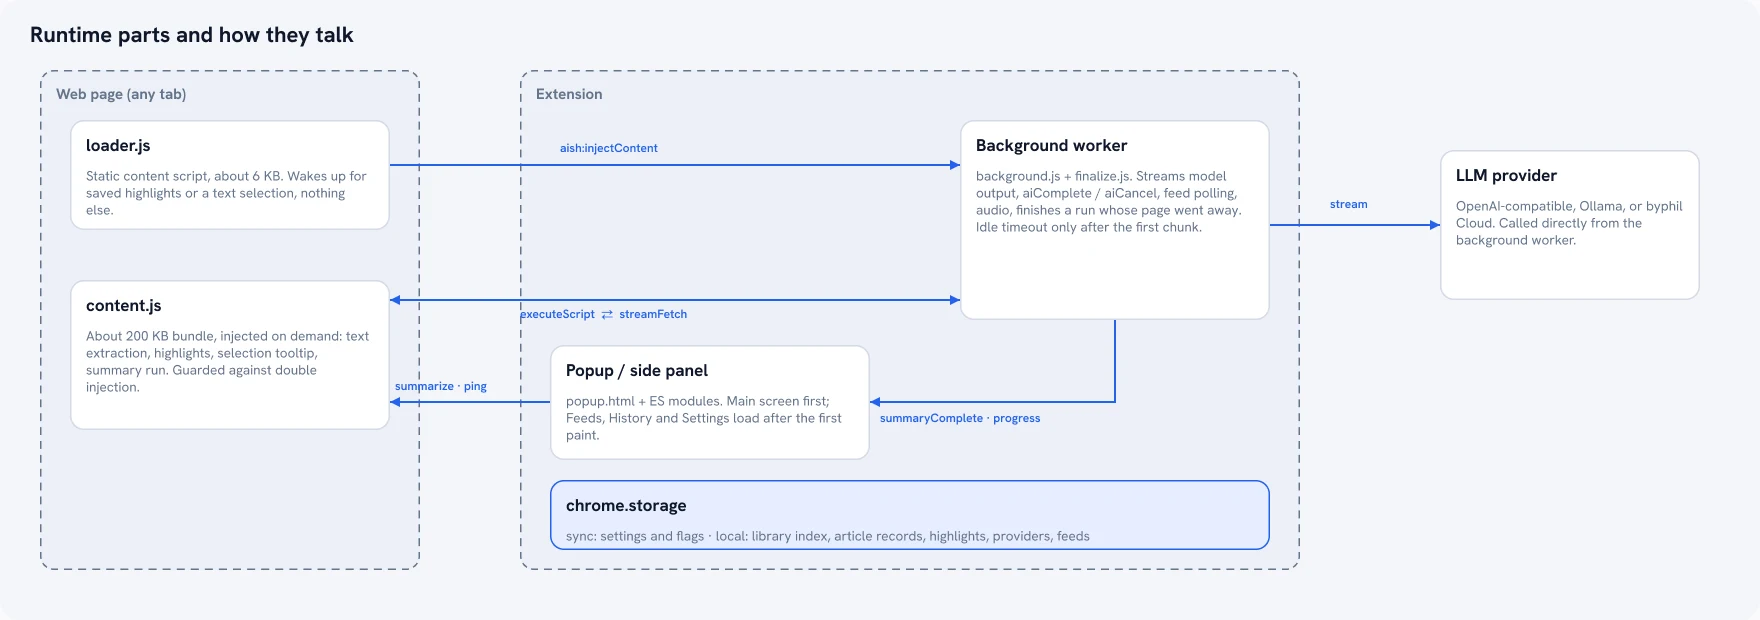
Langkah perangkuman yang sebenarnya — bagian yang benar-benar membutuhkan language model — masih memerlukan panggilan jaringan. Belum ada cara lain dengan ukuran model on-device saat ini jika Anda menginginkan kualitas output setara model cloud. Pengguna dapat membawa API key sendiri untuk langkah tersebut (OpenAI, Gemini, Mistral, DeepSeek), atau mengarahkan ekstensi ke instance lokal Ollama dan melewati jaringan sepenuhnya untuk langkah itu juga. Itulah satu-satunya bagian di mana "on-device" bukan menjadi default — melainkan opt-in, karena adanya trade-off nyata: model lokal lebih lambat dan kualitasnya lebih rendah daripada model hosted, dan kami tidak ingin berpura-pura sebaliknya.
Mengapa ini lebih dari sekadar topik pembicaraan privasi
Aspek privasi memang nyata — ekstensi dengan izin host yang luas mengirimkan konten halaman ke server untuk hal-hal yang tidak memerlukannya adalah masalah kepercayaan yang sah, bukan sekadar pencitraan. Namun alasan yang lebih mendasar adalah karena ini memang keputusan engineering yang tepat. Pencarian TF-IDF tidak butuh latensi jaringan 200ms. Deduplikasi tag tidak perlu dibebani tagihan API. Menyesuaikan alat dengan kebutuhan sebenarnya, alih-alih mengarahkan semuanya lewat "panggilan ke cloud" secara default, cenderung menghasilkan sesuatu yang lebih cepat, lebih hemat biaya operasional, dan lebih andal saat offline — manfaat privasi didapatkan secara cuma-cuma, bukan sebaliknya.
AI Summary Helper adalah ekstensi Chrome gratis.
Tambahkan ke Chrome