 AI Summary Helper
Perché abbiamo portato ricerca, tag e suggerimenti fuori dal cloud
Ricerca, deduplicazione, pulizia dei tag e suggerimenti condividono un unico piccolo indice sul tuo dispositivo. Ecco come funziona e perché non è solo un argomento di facciata sulla privacy.
La maggior parte delle estensioni per browser «basate sull'IA» invia ogni cosa a un server — comprese le parti che non hanno nulla a che fare con l'IA. Ricerca, pulizia dei tag, «trova elementi simili»: sono tecniche consolidate da decenni. Non richiedono un modello linguistico e sicuramente non hanno bisogno di chiamate di rete. Abbiamo esaminato AI Summary Helper funzione per funzione e ci siamo chiesti: serve davvero il cloud, o lo stiamo usando per inerzia solo perché è l'architettura più semplice?
Per la maggior parte, non serviva affatto.
Cosa è stato effettivamente spostato sul dispositivo
Ricerca. In origine l'estensione effettuava la corrispondenza solo su titolo e tag dell'articolo — veloce, ma cieca rispetto al corpo del testo. Invece di scansionare a forza bruta il testo completo a ogni pressione dei tasti o inviare ogni query a un server, abbiamo creato un piccolo indice TF-IDF a partire dal tuo archivio salvato. I campi più leggeri — titolo, tag — vengono verificati prima e all'istante, come in precedenza. Le query più lunghe vengono estese sull'indice, che viene creato una volta per sessione e aggiornato in modo incrementale, senza ripetere la scansione a ogni tasto premuto.
Rilevamento duplicati. Prima di completare un salvataggio, viene eseguito un controllo a livelli: prima la corrispondenza esatta dell'URL normalizzato (leggera, O(1)), poi la similarità del titolo sui pochi candidati che superano il filtro, e solo infine — per i pochissimi rimanenti — un confronto completo di similarità del coseno via TF-IDF. La maggior parte dei salvataggi non raggiunge mai il livello più pesante, perché i livelli più veloci hanno già risolto la richiesta.
Normalizzazione dei tag. Nel tempo i tag tendono a disallinearsi: «ML», «Machine Learning», «machine-learning» hanno lo stesso significato per un essere umano, ma sono completamente diversi per un filtro. Una piccola tabella di alias gestisce i casi ovvi; un'unione fuzzy basata sulla distanza di modifica sull'intero vocabolario dei tag gestisce il resto, scegliendo la grafia che usi più spesso come forma canonica invece di importene una «corretta».
Leggibilità e tono. Il punteggio Flesch–Kincaid è pura aritmetica sul conteggio di frasi e sillabe — nessun modello richiesto. La sentiment analysis usa un elenco di parole AFINN integrato con un piccolo controllo delle negazioni sui due token precedenti. Nessuno di questi elementi ha mai avuto bisogno di uscire dal browser.
«Articoli simili» e Digest. Entrambi riutilizzano gli stessi identici vettori TF-IDF già creati per la ricerca. Sarebbe stato facile realizzare tre sistemi di similarità separati per tre funzioni diverse. Creare un unico indice e consentire a ricerca, suggerimenti e selezione del digest di leggerlo ha mantenuto il sistema più leggero e ha permesso di migliorare tutte e tre le funzionalità con un unico aggiornamento dell'indice.
Cosa abbiamo volutamente lasciato nel cloud
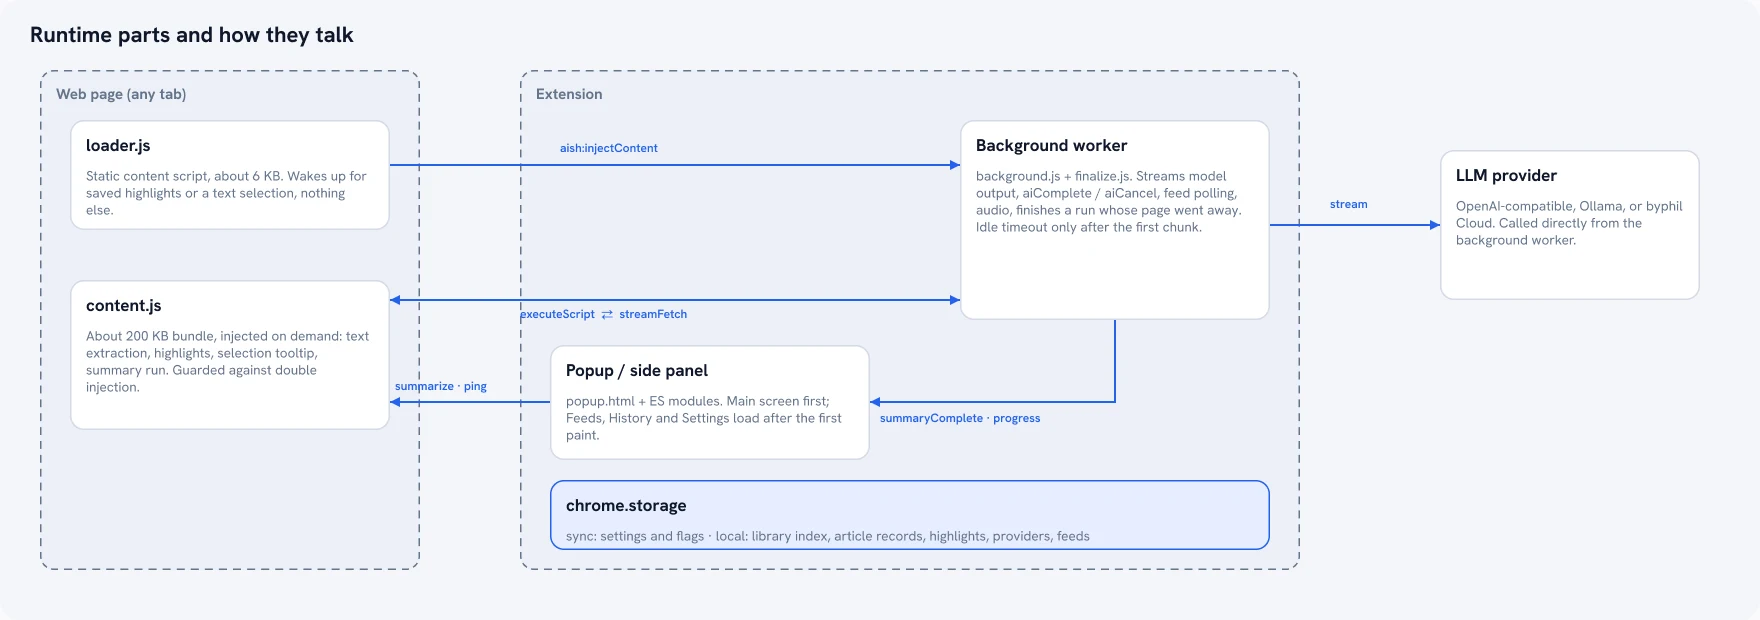
Il passaggio vero e proprio di riassunto — la parte che richiede autenticamente un modello linguistico — necessita ancora di una chiamata di rete. Con le attuali dimensioni dei modelli on-device non ci sono alternative se desideri la qualità di output dei modelli cloud. Per questa fase puoi usare la tua chiave API (OpenAI, Gemini, Mistral, DeepSeek) o puntare l'estensione a un'istanza locale di Ollama ed evitare la rete anche qui. Questo è l'unico punto in cui il funzionamento on-device non è predefinito ma opzionale, perché il compromesso è reale: un modello locale è più lento e offre una qualità inferiore rispetto a uno hosted, e non volevamo fingere il contrario.
Perché non è solo un argomento di facciata sulla privacy
L'aspetto legato alla privacy (e alla conformità GDPR) è reale: un'estensione con ampi permessi di host che invia i contenuti delle pagine a un server per operazioni non necessarie solleva legittimi dubbi di fiducia, non è solo una questione di immagine. Ma il motivo più pragmatico per farlo è che si tratta semplicemente della scelta ingegneristica corretta. La ricerca TF-IDF non ha bisogno di 200 ms di latenza di rete. La deduplicazione dei tag non richiede costi API. Scegliere lo strumento giusto per il lavoro effettivo, invece di instradare tutto verso il cloud per impostazione predefinita, permette di ottenere una soluzione più veloce, economica da gestire e resiliente anche offline — e la tutela della privacy ne è una naturale conseguenza, non il contrario.
AI Summary Helper è un'estensione gratuita per Chrome.
Aggiungi a Chrome